MTTF, MTBF and THR: How to Calculate Reliability and Hazard Rates in Railway RAMSMTTF, MTBF i THR: jak obliczać niezawodność i intensywność zagrożeń w kolejowym RAMS
A practical guide to failure rate, FIT, MTTF, MTBF, MTTR, availability and Tolerable Hazard Rate (THR) in railway RAMS per EN 50126 and EN 50129, with step-by-step worked examples for series, redundant and 2oo2 fail-safe systemsPraktyczny przewodnik po intensywności uszkodzeń, FIT, MTTF, MTBF, MTTR, gotowości i dopuszczalnej intensywności zagrożeń (THR) w kolejowym RAMS wg EN 50126 i EN 50129, z przykładami obliczeń krok po kroku dla układów szeregowych, redundantnych i bezpiecznych układów 2oo2
Every railway RAMS plan ends up full of numbers: FIT values from a supplier, an MTBF on a datasheet, an availability target in the contract, a THR assigned to a hazard. They look alike, they share units, and they are mixed up all the time.
This post explains what each one means, how they relate, and how to calculate them, with worked examples you can check by hand.
The context is railway signalling and rolling stock under EN 50126 and EN 50129, but the reliability maths is the same in any industry. It is written for systems, RAMS and safety engineers who need to produce or review these numbers.
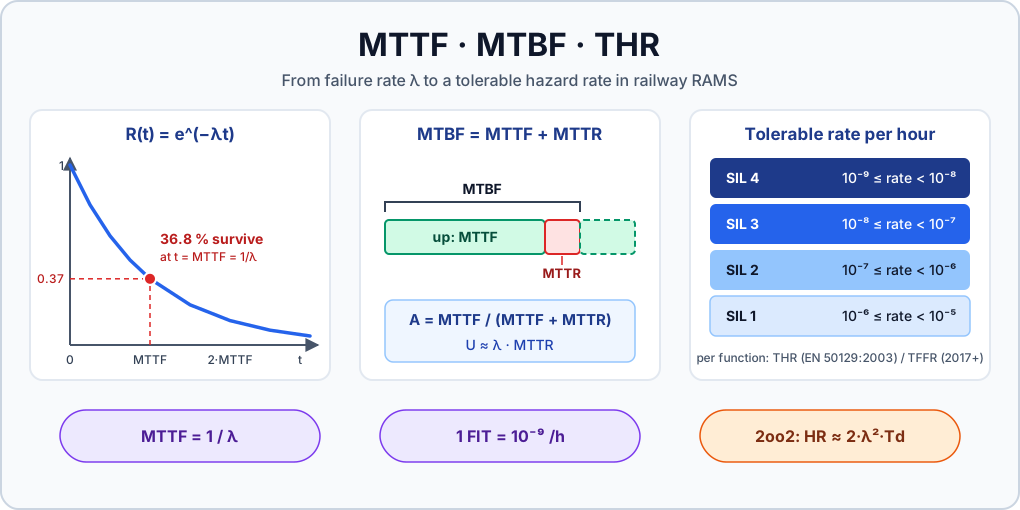
MTTF, MTBF and THR at a glance: the exponential reliability curve, the repair cycle and the SIL rate bands
The Failure Rate λ
The failure rate λ (lambda) is the number of failures per unit of time, usually per hour. If a component has λ = 1e-6 /h, a population of one million such components running for one hour is expected to produce about one failure.
Almost every calculation below relies on one assumption: λ is constant.
The Bathtub Curve
The failure rate of a hardware population over its life usually looks like a bathtub:
λ(t)
 │\                                   /
 │ \                                 /
 │  \_______________________________/
 │  early     useful life          wear-out
 │  failures  (λ ≈ constant)       (λ rising)
 └──────────────────────────────────────── t
The diagram shows three phases of life. The failure rate falls during early life, stays roughly flat during useful life, and rises again at wear-out.
Early failures (infant mortality): manufacturing defects, weak parts. Reduced by burn-in, screening and environmental stress testing.
Useful life: random failures at a roughly constant rate. This is where the constant-λ model applies.
Wear-out: fatigue, electrolytic capacitor drying, relay contact wear, connector fretting. Handled by preventive maintenance and replacement before wear-out, not by λ.
A constant failure rate means the time to failure follows an exponential distribution. That gives us simple closed-form formulas.
It also means the formulas are only valid inside the useful-life period. They say nothing about how long a part lasts before it wears out.
When constant λ does not apply
Mechanical parts, relays, batteries and anything subject to wear do not follow a constant failure rate. Software failures are systematic, not random. They are handled by SIL processes (EN 50128, now EN 50716), not by λ.
FIT
Electronic component failure rates are tiny, so they are often given in FIT (Failures In Time):
1 FIT = 1 failure per 10^9 device-hours = 1e-9 /hλ [/h] = FIT · 1e-9
Eq. 1 – FIT
So 100 FIT = 1e-7 /h. FIT is convenient because FIT values add up for components in series. Sum the FITs, then convert once.
MTTF, MTTR and MTBF
MTTF: Mean Time To Failure
MTTF is the expected time until the first failure of an item. For a constant failure rate:
MTTF = 1 / λ
Eq. 2 – Mean time to failure (constant λ)
MTTF is the right metric for non-repairable items (a component, a sealed module) and for the time to the first failure of a repairable one.
MTTR: Mean Time To Restore
MTTR is the average time from failure to restored function. In railway practice, be clear what it includes. It may cover any of these:
detection of the failure,
travel to site,
diagnosis and replacement,
testing and return to service,
or only the “hands-on” repair time.
A contract that says “MTTR = 30 min” and a maintainer that means “time with the screwdriver” will disagree badly about availability.
MTBF: Mean Time Between Failures
For a repairable item, MTBF is the average time from one failure to the next. It covers one working period and one repair period:
MTBF = MTTF + MTTR
Eq. 3 – Mean time between failures
In most electronics MTTR is hours and MTTF is tens of thousands of hours or more, so MTBF ≈ MTTF. That is why many datasheets use “MTBF” when they really mean 1/λ.
It does no harm numerically, but you should know which one you are reading.
Reliability R(t)
Reliability is the probability that the item survives without failure until time t:
R(t) = e^(−λ·t)F(t) = 1 − R(t) (probability of failure by time t)F(t) ≈ λ·t (valid when λ·t << 1)
Eq. 4 – Reliability and probability of failure
Now the most important trap in this post. Put t = MTTF:
R(MTTF) = e^(−λ · 1/λ) = e^(−1) ≈ 0.368
Eq. 5 – Survival probability at t = MTTF
MTTF is not a lifetime
Only 36.8% of units survive to their MTTF; 63.2% have already failed. A part with an MTTF of 1,000,000 hours (about 114 years) does not last 114 years.
It means that during its useful life, a large population fails at a rate of one per million unit-hours. Wear-out may well end its life after 15 years.
Availability
Steady-state (inherent) availability is the long-run fraction of time the item can do its job:
You will often see A = MTBF / (MTBF + MTTR). That form is right only when “MTBF” is being used for the up-time (that is, MTTF). Using the strict definition MTBF = MTTF + MTTR, the correct expression is MTTF/MTBF. When MTTR << MTTF the difference does not matter numerically, but it does matter in a review.
Inherent availability ignores logistics delays and preventive maintenance downtime. Operational availability is always lower.
System Structures
Series Systems
If the system fails when any element fails (a reliability series structure), the failure rates add up:
Redundancy without repair only adds 50% to MTTF. The second channel buys you time, not immortality.
With repair, the model changes. Assume a repair rate μ = 1/MTTR, the failed channel is repaired while the other one runs, and the system fails only when both are down:
This is where redundancy really pays off: system MTTF grows with the square of the channel MTTF, divided by MTTR.
Repair needs detection
Eq. 9 assumes the failure of one channel is noticed straight away. If you do not know a channel has failed, you cannot repair it, and you are back to Eq. 8. Undetected failures of a redundant channel quietly remove most of the benefit.
k-out-of-n
The general case is k-out-of-n (koon): the system works while at least k of n channels work. For identical, non-repairable channels:
MTTF_koon = (1/λ) · Σ (1/i) for i = k … nMTTF_2oo3 = (1/λ) · (1/2 + 1/3) = 5 / (6λ)
Eq. 10 – k-out-of-n without repair
A 2oo3 without repair has an MTTF lower than a single channel (5/6 of it). Over the long run it is less reliable than a simplex channel.
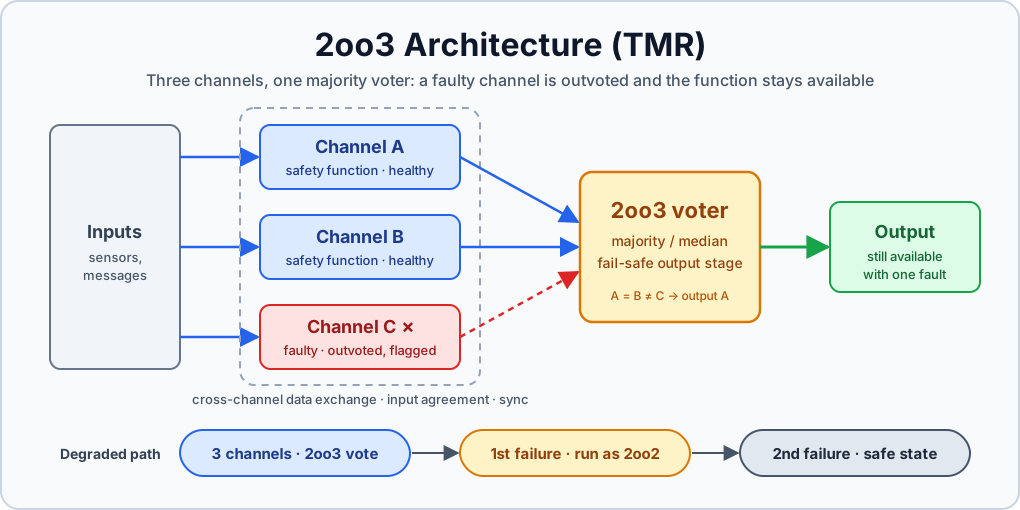
Its value comes from fault tolerance with repair, and from masking a single faulty channel. See 2oo3 architecture for the full picture.
Reliability view versus safety view
These are reliability structures (does the function survive?). Safety is a different question. A 2oo2 system is a series structure for reliability (either channel failing stops the train) but a redundant structure for safety (both channels must fail dangerously for a hazard). Always state which view a block diagram represents.
THR: Tolerable Hazard Rate
What THR Is
The Tolerable Hazard Rate (THR) is the maximum rate, per hour, at which a given hazard may occur and still keep the associated risk acceptable. It comes from risk analysis:
Start from accident severity and frequency.
Account for the barriers between hazard and accident.
Arrive at a tolerable rate for the hazard at the system boundary.
Note the word: Tolerable, not “Target”. THR is a ceiling set by risk acceptance, not an aspiration.
It is defined in the EN 50126 series and used in EN 50129 for the safety case of safety-related electronic signalling equipment.
THR is not a failure rate
A failure rate describes how often an item stops doing what it should. A hazard rate describes how often the system ends up in a state that can lead to an accident.
Most failures are not hazardous: many are “right-side” failures that put the system into a safe state.
A hazard may arise without any hardware failure, for example from a specification error or an operator action.
Comparing a board’s total λ with a THR is meaningless.
THR and SIL
EN 50129:2003 related the THR, per hour and per function, directly to a SIL through a table of rate bands (Table A.1).
In the 2017/2018 editions (EN 50126-2:2017 and EN 50129:2018), the hazard-level THR is apportioned down to safety-related functions. The tolerable rate assigned to a function is called the TFFR (Tolerable Functional unsafe Failure Rate). The SIL of the function is read from the same rate bands:
SIL
Tolerable rate per hour, per function
4
1e-9 ≤ rate < 1e-8
3
1e-8 ≤ rate < 1e-7
2
1e-7 ≤ rate < 1e-6
1
1e-6 ≤ rate < 1e-5
Because the bands did not change, “THR” and “SIL band” are still used together in many projects. Check the edition your project is contracted against, as the terminology and the apportionment process differ.
SIL is about systematic integrity. The SIL tells you which process, techniques and measures apply (for example EN 50128 or EN 50716 for software).
The quantitative rate is demonstrated separately, for random hardware failures. You need both.
A low calculated hazard rate does not give you a SIL.
SIL 4 is the ceiling. If the apportioned requirement is tighter than 1e-9 /h, there is no “SIL 5”. The function is then normally split, or extra independent barriers are added at system level.
Apportioning THR
THR is set for a hazard at the system boundary. It must then be broken down through the architecture, usually with a fault tree.
Suppose (illustrative numbers) the hazard “train exceeds its movement authority” has THR = 1e-9 /h, and the fault tree shows three independent causes combined by an OR gate:
H: train exceeds movement authority THR = 1.0e-9 /h└── OR ├── onboard speed/position supervision alloc. 5.0e-10 /h ├── trackside movement authority wrong alloc. 3.0e-10 /h └── data corruption on radio link alloc. 2.0e-10 /h sum = 1.0e-9 /h ✓
The tree shows one hazard at the top and three causes under an OR gate, each with its allocated rate.
For an OR gate, the rates add up, so the allocations must sum to no more than the THR.
For an AND gate (two independent things must both go wrong), the combined rate depends on how long the first condition persists. That brings us to detection time.
From Component Failure Rates to Function Hazard Rate
The hardware failure rate of a channel is not its hazard rate. To get from one to the other, take three steps:
Split failure modes into safe and dangerous. Only some failure modes can cause a wrong-side outcome (an output more permissive than it should be); the rest lead to a safe state or have no effect.
EN 50129 defines how to identify component failure modes and which ones may be excluded.
Split dangerous failures into detected and undetected. Diagnostics (self-tests, cross-checks, watchdogs, readback) detect a share of dangerous failures and force a safe state. That share is the diagnostic coverage DC.
Account for detection and negation time. A detected dangerous failure is not harmless until the safe state is actually reached.
The relevant time Td includes the time to detect the fault (test interval, comparison cycle).
It also includes the time to negate it (cut the output, drop the vital relay, apply the brake).
As a single channel, the undetected part alone is already at the SIL 3/SIL 4 boundary. That is before counting the detected failures that are still dangerous during Td.
This is why SIL 4 signalling equipment is almost always built as a composite fail-safe system (2oo2 or 2oo3) rather than a single channel with diagnostics.
Hazard Rate of a 2oo2 Composite Fail-Safe System
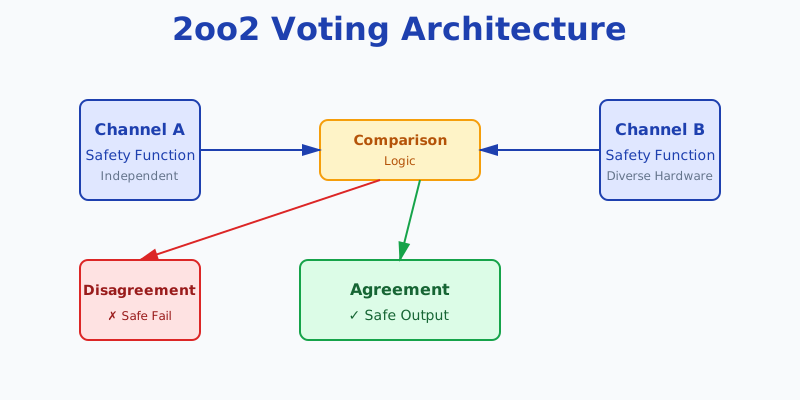
In a 2oo2 system, two channels compute the same output. A comparator (or the output stage) only allows a permissive output if both agree.
A single dangerous failure is detected by disagreement, and the system is forced to a safe state within Td. A hazard needs both channels to fail dangerously, the second one before the first has been detected and negated.
Assumptions:
Both channels have the same dangerous failure rate λ (per hour), constant.
Failures of the two channels are independent (common cause is treated separately below).
Any dangerous failure in one channel is detected and negated within Td.
λ·Td << 1.
Conservative simplification: any second dangerous failure within Td leads to the hazard. In reality both channels would have to fail in a way that produces the same wrong output, so this is pessimistic.
Derivation:
The rate at which a first dangerous failure occurs in either channel is 2λ.
Given that, the probability that the other channel also fails dangerously within the window Td is 1 − e^(−λ·Td) ≈ λ·Td.
If faults are only revealed by a periodic test of interval T rather than continuously, the average exposure is about T/2. Using the full T as Td is the conservative choice.
Common cause failures. A common cause failure (CCF) hits both channels at once, with the same wrong output, so the comparator cannot see it. With the β-factor model, a fraction β of each channel’s dangerous failure rate is assumed to be common cause:
HR_total ≈ 2·λ²·Td + β·λ
Eq. 14 – 2oo2 hazard rate with the β-factor model
As Example 3 shows, the β·λ term dominates very quickly. This is why EN 50129 requires composite fail-safe systems to show physical and functional independence of the channels rather than relying on a small β in a calculation. Typical measures:
physical separation,
diversity,
independent power supplies,
protection against shared environmental stress.
Worked Examples
All component values below are illustrative, chosen to make the arithmetic easy to follow. They are not taken from any reliability database or real product.
Example 1: Board Failure Rate from FIT Values
A control board has the following parts, all needed for it to work (series model). The table lists the FIT value per part and the total per line:
Item
Qty
FIT each
FIT total
Microcontroller
1
60
60
DC/DC converter
2
25
50
External flash
1
20
20
CAN transceiver
1
15
15
Crystal oscillator
1
10
10
Connectors
1 set
15
15
Passives (R, C)
80
0.5
40
Total
210
λ = 210 FIT = 210 · 1e-9 /h = 2.1e-7 /hMTTF = 1 / 2.1e-7 /h ≈ 4.76e6 h ≈ 544 years
Ex. 1, steps 1–2 – Failure rate and MTTF
Clearly not a lifetime. It says that in useful life, the board population fails at 2.1e-7 per board-hour.
Ex. 1, step 3 – Reliability over one year (t = 8,760 h)
N_fail/year = 1000 · 8760 h · 2.1e-7 /h ≈ 1.84
Ex. 1, step 4 – Expected failures in a fleet of 1,000 boards
Result
A fleet of 1,000 boards in continuous service should expect about 1.8 failures per year. That is a number a maintenance planner can use. The 544-year MTTF is not.
Example 2: Availability with MTTR
A trackside unit has MTTF = 50,000 h. Two maintenance concepts are compared:
A = 50,000 / (50,000 + 4) ≈ 0.99992U = 1 − A ≈ 8.0e-5downtime/year = 8.0e-5 · 8760 h ≈ 0.70 h ≈ 42 min
Ex. 2, case A – MTTR = 4 h (spares on site, trained staff)
A = 50,000 / (50,000 + 24) ≈ 0.99952U ≈ 4.8e-4downtime/year = 4.8e-4 · 8760 h ≈ 4.2 h
Ex. 2, case B – MTTR = 24 h (spares at a central depot, travel included)
Same hardware, six times more downtime. Availability is often decided by the maintenance concept as much as by the design.
Case C looks at redundancy instead. Two units in 1oo2, each with λ = 1e-4 /h (MTTF 10,000 h), MTTR = 8 h (μ = 0.125 /h):
Against a single unit (10,000 h), redundancy without repair gives 1.5 times the MTTF. With repair it gives more than 600 times (6.27e6 h / 10,000 h ≈ 627), provided the failure of one unit is detected and reported.
Example 3: 2oo2 Composite Fail-Safe System
Two channels, each with dangerous failure rate λ = 1e-5 /h. A dangerous failure in one channel is detected by cross-comparison and negated within Td = 1 h.
Step 2 compares this with the SIL bands. 2.0e-10 /h is below 1e-9 /h, so for random hardware failures alone it would meet any tolerable rate in the SIL 4 band (1e-9 ≤ rate < 1e-8).
The margin is 5 against the lower bound and 50 against the upper bound. Each channel on its own (1e-5 /h) would not even reach SIL 1.
Step 3 checks sensitivity to Td. The hazard rate is linear in Td:
Td
HR (/h)
Compared with the SIL 4 band
0.1 h (6 min)
2.0e-11
well below
1 h
2.0e-10
below
10 h
2.0e-9
inside the SIL 4 band
24 h
4.8e-9
inside the SIL 4 band, little margin
100 h
2.0e-8
above it (SIL 3 band)
A fault that sits unnoticed for a few days destroys the benefit of the second channel. Fast, frequent comparison and a prompt, reliable negation path are worth more than a better component.
Step 4 checks sensitivity to common cause. The table adds the CCF term β·λ (Eq. 14), with λ = 1e-5 /h and Td = 1 h:
β
β·λ (/h)
HR_total (/h)
0
0
2.0e-10
1e-5 (0.001%)
1.0e-10
3.0e-10
1e-4 (0.01%)
1.0e-9
1.2e-9
1e-3 (0.1%)
1.0e-8
1.02e-8
1e-2 (1%)
1.0e-7
1.0e-7
To keep HR_total below 1e-9 /h, the CCF term must stay below 1e-9 − 2e-10 = 8e-10 /h:
β · 1e-5 /h < 8e-10 /hβ < 8e-5 (0.008 %)
Ex. 3, step 4 – Maximum β for HR_total < 1e-9 /h
Result
Independent failures give 2.0e-10 /h, but β must stay below 8e-5 to keep the total under 1e-9 /h.
That is far below the β values commonly used for redundant electronics, which are in the percent range. A β-factor calculation alone will not get a 2oo2 system to SIL 4.
The argument has to rest on demonstrated independence between channels, plus detection of common-cause effects (for example, monitoring of shared power supplies and temperature).
Only then are the remaining undetected, identical common-cause failures credibly negligible.
Common Mistakes
The same errors turn up in RAMS reports again and again:
Treating MTBF as expected life. An MTBF of 200,000 hours does not mean the unit lasts 23 years. At t = MTBF, about 63% of units have failed (if the exponential model even still applies).
Service life is limited by wear-out, which constant-λ models ignore.
Mixing per-hour and per-demand measures. Railway THR and TFFR are per hour. IEC 61508 low-demand functions use PFD (probability of failure on demand), which has no unit.
A PFD of 1e-4 is not comparable to a rate of 1e-4 /h.
Do not mix them in one fault tree without converting through the demand rate and exposure time.
Ignoring common cause failures. The 2λ²Td term looks wonderful, but as Example 3 shows, even a tiny β wipes it out.
Any redundant architecture claim without a CCF argument is incomplete.
Confusing THR with failure rate. THR is a requirement on the rate of a hazard. A failure rate is a property of an item.
Most failures are right-side, and the hazard rate depends on architecture, diagnostics and detection time.
Ignoring detection and negation time. Two channels are only better than one if a failure of the first is detected and negated quickly.
Latent faults that are only found at the next maintenance visit turn Td from seconds into months.
Using MIL-HDBK-217 (or any handbook) blindly. Prediction handbooks are a way to compare designs and to get a starting point, not a measurement of field reality.
MIL-HDBK-217F dates from the 1990s and is widely considered to give pessimistic results for modern components.
Other sources (IEC 61709 reference conditions, SN 29500, FIDES, supplier field data) give different numbers for the same part.
Whatever source you use, state it along with the environment and temperature assumptions, and apply it consistently.
Check it against field return data once you have some.
Unit errors. The usual suspects:
per hour versus per year (a factor of 8,760),
FIT versus /h (a factor of 1e9),
operating hours versus calendar hours (a vehicle that runs 18 hours a day),
per function versus per system.
Applying constant λ where it does not hold. Mechanical parts, relays, batteries and software do not follow a constant failure rate.
Write units on every line
In practice, many wrong RAMS numbers come from unit errors rather than maths errors. Write the unit next to every number in the calculation, not just in the final result.
Formula Summary
The table collects the formulas used in this post, with the conditions under which each one is valid:
EN 50126-1:2017 and EN 50126-2:2017 (RAMS process, THR apportionment, TFFR)
EN 50129:2018 (safety-related electronic systems for signalling); EN 50129:2003 for the older THR-to-SIL table
IEC 61508-6, Annex D (β-factor method for common cause failures)
IEC 61709 (reference conditions for component failure rates)
Każdy kolejowy plan RAMS prędzej czy później wypełnia się liczbami: wartości FIT od dostawcy, MTBF z karty katalogowej, wymagana gotowość w kontrakcie, THR przypisana do zagrożenia. Wyglądają podobnie, mają te same jednostki i ciągle się je myli.
W tym artykule wyjaśniam, co oznacza każda z tych wielkości, jak się ze sobą wiążą i jak je obliczyć. Wszystkie przykłady da się sprawdzić ręcznie.
Tłem są urządzenia sterowania ruchem kolejowym (srk) i tabor według EN 50126 i EN 50129, ale matematyka niezawodności jest taka sama w każdej branży. Tekst kieruję do inżynierów systemowych, RAMS i bezpieczeństwa, którzy te liczby wyznaczają albo sprawdzają.
MTTF, MTBF i THR w skrócie: wykładnicza krzywa niezawodności, cykl naprawy i przedziały intensywności dla SIL
Intensywność uszkodzeń λ
Intensywność uszkodzeń λ (lambda) to liczba uszkodzeń na jednostkę czasu, zwykle na godzinę. Jeśli komponent ma λ = 1e-6 /h, to milion takich komponentów pracujących przez godzinę da średnio około jednego uszkodzenia.
Niemal wszystkie dalsze obliczenia opierają się na jednym założeniu: λ jest stała.
Krzywa wannowa
Intensywność uszkodzeń populacji sprzętu w ciągu jej życia zwykle przypomina przekrój wanny:
Wykres pokazuje trzy okresy życia. Na początku intensywność uszkodzeń spada, w okresie normalnej eksploatacji jest w przybliżeniu stała, a w okresie zużycia znów rośnie.
Uszkodzenia wczesne (okres docierania, infant mortality): wady produkcyjne, słabe egzemplarze. Ogranicza się je wygrzewaniem (burn-in), selekcją i próbami narażeniowymi.
Normalna eksploatacja (useful life): uszkodzenia losowe o w przybliżeniu stałej intensywności. Tylko tu obowiązuje model stałej λ.
Zużycie (wear-out): zmęczenie materiału, wysychanie kondensatorów elektrolitycznych, zużycie styków przekaźników, fretting złączy. Przeciwdziała się mu obsługą profilaktyczną i wymianą przed zużyciem, a nie wartością λ.
Stała intensywność uszkodzeń oznacza, że czas do uszkodzenia ma rozkład wykładniczy. Dzięki temu wzory mają prostą, zamkniętą postać.
Oznacza to jednak również, że wzory obowiązują tylko w okresie normalnej eksploatacji. Nie mówią nic o tym, ile część wytrzyma, zanim się zużyje.
Kiedy λ nie jest stała
Części mechaniczne, przekaźniki, akumulatory i wszystko, co się zużywa, nie ma stałej intensywności uszkodzeń. Uszkodzenia oprogramowania są systematyczne, a nie losowe. Panuje się nad nimi procesem właściwym dla SIL (EN 50128, obecnie EN 50716), a nie wartością λ.
FIT
Intensywności uszkodzeń elementów elektronicznych są bardzo małe, dlatego często podaje się je w FIT (Failures In Time):
1 FIT = 1 uszkodzenie na 10^9 godzin pracy = 1e-9 /hλ [/h] = FIT · 1e-9
Wz. 1 – FIT
Zatem 100 FIT = 1e-7 /h. Jednostka jest wygodna, bo dla elementów połączonych szeregowo wartości FIT się sumują. Najpierw dodaje się FIT, a jednostki przelicza raz, na końcu.
MTTF, MTTR i MTBF
MTTF: średni czas do uszkodzenia
Średni czas do uszkodzenia (MTTF) to oczekiwany czas do pierwszego uszkodzenia obiektu. Przy stałej intensywności uszkodzeń:
MTTF = 1 / λ
Wz. 2 – Średni czas do uszkodzenia (stała λ)
MTTF jest właściwą miarą dla obiektów nienaprawialnych (element, zamknięty moduł) oraz dla czasu do pierwszego uszkodzenia obiektu naprawialnego.
MTTR: średni czas przywrócenia
Średni czas przywrócenia (MTTR) to średni czas od uszkodzenia do przywrócenia funkcji. W praktyce kolejowej trzeba jasno ustalić, co się w nim mieści. Może obejmować:
wykrycie uszkodzenia,
dojazd na miejsce,
diagnozę i wymianę,
sprawdzenie i przywrócenie do eksploatacji,
albo tylko sam czas pracy przy urządzeniu.
Jeśli w kontrakcie zapisano „MTTR = 30 min”, a służby utrzymania rozumieją przez to „czas ze śrubokrętem w ręku”, obie strony dojdą do zupełnie innej gotowości.
MTBF: średni czas między uszkodzeniami
Dla obiektu naprawialnegośredni czas między uszkodzeniami (MTBF) to średni czas od jednego uszkodzenia do następnego. Obejmuje jeden okres pracy i jeden okres naprawy:
MTBF = MTTF + MTTR
Wz. 3 – Średni czas między uszkodzeniami
W większości urządzeń elektronicznych MTTR liczy się w godzinach, a MTTF w dziesiątkach tysięcy godzin lub więcej, więc MTBF ≈ MTTF. Dlatego wiele kart katalogowych podaje „MTBF”, choć w rzeczywistości chodzi o 1/λ.
Liczbowo nie ma to znaczenia, ale trzeba wiedzieć, którą wielkość się czyta.
Niezawodność R(t)
Niezawodność R(t) to prawdopodobieństwo, że obiekt będzie pracował bez uszkodzenia do chwili t:
R(t) = e^(−λ·t)F(t) = 1 − R(t) (prawdopodobieństwo uszkodzenia do chwili t)F(t) ≈ λ·t (gdy λ·t << 1)
Wz. 4 – Niezawodność i prawdopodobieństwo uszkodzenia
A teraz najważniejsza pułapka w tym artykule. Podstawmy t = MTTF:
R(MTTF) = e^(−λ · 1/λ) = e^(−1) ≈ 0,368
Wz. 5 – Prawdopodobieństwo przetrwania w chwili t = MTTF
MTTF nie jest czasem życia
Do swojego MTTF dożywa tylko 36,8% egzemplarzy; 63,2% jest już uszkodzonych. Element o MTTF równym 1 000 000 godzin (około 114 lat) wcale nie przetrwa 114 lat.
Ta liczba mówi tylko, że w okresie normalnej eksploatacji duża populacja takich elementów ulega jednemu uszkodzeniu na milion godzin pracy. Zużycie może zakończyć ich życie już po 15 latach.
Gotowość
Gotowość wewnętrzna (inherent availability) w stanie ustalonym to część czasu, w której obiekt – w długim okresie – może wykonywać swoją funkcję:
Często spotyka się wzór A = MTBF / (MTBF + MTTR). Jest poprawny tylko wtedy, gdy „MTBF” oznacza czas zdatności, czyli MTTF. Przy ścisłej definicji MTBF = MTTF + MTTR poprawne wyrażenie to MTTF/MTBF. Gdy MTTR << MTTF, różnica liczbowo nie ma znaczenia, ale podczas przeglądu dokumentacji – już tak.
Gotowość wewnętrzna pomija opóźnienia logistyczne i przestoje na obsługę profilaktyczną. Gotowość operacyjna jest zawsze niższa.
Struktury systemów
Układy szeregowe
Jeśli system ulega uszkodzeniu, gdy uszkodzi się dowolny element (szeregowa struktura niezawodnościowa), intensywności uszkodzeń się sumują:
To model „parts count”, stosowany dla większości pakietów elektronicznych.
Redundancja równoległa: 1oo2
Struktura 1oo2 (jeden z dwóch) działa, dopóki sprawny jest co najmniej jeden z dwóch kanałów. Dla dwóch identycznych kanałów o intensywności uszkodzeń λ:
Redundancja bez naprawy wydłuża MTTF tylko o 50%. Drugi kanał daje czas, a nie nieśmiertelność.
Z naprawą model wygląda inaczej. Zakładamy intensywność napraw μ = 1/MTTR, naprawę uszkodzonego kanału podczas pracy drugiego i uszkodzenie systemu dopiero wtedy, gdy oba kanały są niesprawne:
Dopiero tu redundancja naprawdę się opłaca: MTTF systemu rośnie z kwadratem MTTF kanału, podzielonym przez MTTR.
Naprawa wymaga wykrycia
Wz. 9 zakłada, że uszkodzenie jednego kanału zostaje zauważone od razu. Jeśli nikt nie wie, że kanał jest uszkodzony, nikt go nie naprawi – i wracamy do Wz. 8. Niewykryte uszkodzenia kanału redundantnego po cichu odbierają większość korzyści.
k z n
Przypadek ogólny to struktura k z n (koon, k-out-of-n): system działa, dopóki sprawnych jest co najmniej k z n kanałów. Dla identycznych, nienaprawialnych kanałów:
MTTF_koon = (1/λ) · Σ (1/i) dla i = k … nMTTF_2oo3 = (1/λ) · (1/2 + 1/3) = 5 / (6λ)
Wz. 10 – k z n bez naprawy
Układ 2oo3 bez naprawy ma MTTF mniejszy niż pojedynczy kanał (5/6 jego wartości). W długim horyzoncie jest mniej niezawodny od układu jednokanałowego.
Jego wartość bierze się z tolerowania uszkodzeń przy naprawie i z maskowania jednego wadliwego kanału. Szerzej piszę o tym w artykule o architekturze 2oo3.
Ujęcie niezawodnościowe a ujęcie bezpieczeństwa
Powyższe struktury opisują niezawodność (czy funkcja przetrwa?). Bezpieczeństwo to inne pytanie. Układ 2oo2 jest szeregowy z punktu widzenia niezawodności (uszkodzenie któregokolwiek kanału zatrzymuje pociąg), ale redundantny z punktu widzenia bezpieczeństwa (zagrożenie wymaga niebezpiecznego uszkodzenia obu kanałów). Na każdym schemacie blokowym zaznaczaj, które ujęcie przedstawia.
THR: dopuszczalna intensywność zagrożeń
Czym jest THR
Dopuszczalna intensywność zagrożeń (THR, Tolerable Hazard Rate) to największa intensywność na godzinę, z jaką dane zagrożenie może występować, by związane z nim ryzyko pozostało akceptowalne. Wyznacza się ją w analizie ryzyka:
Punktem wyjścia są ciężkość skutków i częstość wypadku.
Uwzględnia się bariery między zagrożeniem a wypadkiem.
Wynikiem jest dopuszczalna intensywność zagrożenia na granicy systemu.
Warto zwrócić uwagę na słowo Tolerable (dopuszczalna), a nie „Target” (docelowa). THR to górna granica wynikająca z akceptacji ryzyka, a nie cel, do którego się dąży.
Pojęcie definiują normy serii EN 50126, a EN 50129 wykorzystuje je w dowodzie bezpieczeństwa (safety case) elektronicznych urządzeń srk związanych z bezpieczeństwem.
THR to nie intensywność uszkodzeń
Intensywność uszkodzeń mówi, jak często obiekt przestaje działać tak, jak powinien. Intensywność zagrożeń mówi, jak często system trafia w stan, który może doprowadzić do wypadku.
Większość uszkodzeń nie jest niebezpieczna: wiele z nich to uszkodzenia bezpieczne (right-side), które przeprowadzają system w stan bezpieczny.
Zagrożenie może powstać bez żadnego uszkodzenia sprzętu, np. wskutek błędu w specyfikacji albo działania operatora.
Porównywanie całkowitej λ pakietu z THR nie ma więc sensu.
THR a SIL
EN 50129:2003 wiązała THR (na godzinę i na funkcję) bezpośrednio z SIL za pomocą tabeli przedziałów intensywności (Tabela A.1).
W wydaniach z lat 2017–2018 (EN 50126-2:2017 i EN 50129:2018) THR wyznaczoną dla zagrożenia rozdziela się na funkcje związane z bezpieczeństwem. Intensywność przypisaną funkcji nazywa się TFFR (Tolerable Functional unsafe Failure Rate, dopuszczalna intensywność niebezpiecznych uszkodzeń funkcji). SIL funkcji odczytuje się z tych samych przedziałów:
SIL
Dopuszczalna intensywność na godzinę, na funkcję
4
1e-9 ≤ intensywność < 1e-8
3
1e-8 ≤ intensywność < 1e-7
2
1e-7 ≤ intensywność < 1e-6
1
1e-6 ≤ intensywność < 1e-5
Ponieważ przedziały się nie zmieniły, w wielu projektach nadal mówi się jednym tchem o „THR” i „przedziale SIL”. Sprawdź jednak, które wydanie norm wskazuje kontrakt, bo terminologia i sposób rozdziału się różnią.
SIL dotyczy nienaruszalności systematycznej. SIL określa, jaki proces, techniki i środki trzeba zastosować (np. EN 50128 lub EN 50716 dla oprogramowania).
Wartość liczbową dla losowych uszkodzeń sprzętu wykazuje się osobno. Potrzebne jest jedno i drugie.
Niska obliczona intensywność zagrożeń sama w sobie nie daje SIL.
SIL 4 to sufit. Jeśli wymaganie po rozdziale jest ostrzejsze niż 1e-9 /h, nie ma „SIL 5”. Zwykle dzieli się wtedy funkcję albo dodaje niezależne bariery na poziomie systemu.
Rozdział THR
THR ustala się dla zagrożenia na granicy systemu. Potem trzeba ją rozdzielić w dół architektury, najczęściej za pomocą drzewa niezdatności.
Załóżmy (liczby przykładowe), że zagrożenie „pociąg przekracza zezwolenie na jazdę” ma THR = 1e-9 /h, a drzewo niezdatności pokazuje trzy niezależne przyczyny połączone bramką OR:
H: pociąg przekracza zezwolenie na jazdę THR = 1,0e-9 /h└── OR ├── nadzór prędkości/położenia (pokład) przydz. 5,0e-10 /h ├── błędne zezwolenie z części przytor. przydz. 3,0e-10 /h └── przekłamanie danych w łączu radiowym przydz. 2,0e-10 /h suma = 1,0e-9 /h ✓
Drzewo pokazuje zagrożenie na szczycie i trzy przyczyny pod bramką OR, każdą z przydzieloną intensywnością.
Dla bramki OR intensywności się sumują, więc przydziały łącznie nie mogą przekroczyć THR.
Dla bramki AND (muszą zawieść dwie niezależne rzeczy) wynikowa intensywność zależy od tego, jak długo utrzymuje się pierwszy stan. Tu dochodzimy do czasu wykrycia.
Od intensywności uszkodzeń elementów do intensywności zagrożeń funkcji
Intensywność uszkodzeń sprzętu kanału to nie to samo co jego intensywność zagrożeń. Przejście od jednej do drugiej wymaga trzech kroków:
Podział rodzajów uszkodzeń na bezpieczne i niebezpieczne. Tylko część rodzajów uszkodzeń może dać skutek niebezpieczny (wrong-side), czyli wyjście bardziej zezwalające, niż powinno; pozostałe prowadzą do stanu bezpiecznego albo nie mają skutku.
EN 50129 określa, jak identyfikować rodzaje uszkodzeń elementów i które z nich wolno wykluczyć.
Podział uszkodzeń niebezpiecznych na wykryte i niewykryte. Diagnostyka (autotesty, porównania krzyżowe, watchdogi, odczyt zwrotny) wykrywa część uszkodzeń niebezpiecznych i wymusza stan bezpieczny. Ten udział to pokrycie diagnostyczne DC.
Uwzględnienie czasu wykrycia i negacji. Wykryte uszkodzenie niebezpieczne przestaje być groźne dopiero wtedy, gdy system faktycznie osiągnie stan bezpieczny.
Czas Td obejmuje czas wykrycia uszkodzenia (interwał testu, cykl porównania).
Obejmuje też czas jego negacji (odcięcie wyjścia, zwolnienie przekaźnika bezpieczeństwa, uruchomienie hamowania).
W pojedynczym kanale już sama część niewykryta leży na granicy SIL 3 i SIL 4. A to jeszcze bez uszkodzeń wykrytych, które pozostają niebezpieczne przez czas Td.
Dlatego urządzenia srk na poziomie SIL 4 buduje się niemal zawsze jako układy zgodne z zasadą bezpieczeństwa złożonego (composite fail-safety), np. 2oo2 lub 2oo3, a nie jako jeden kanał z diagnostyką.
Intensywność zagrożeń układu 2oo2 o bezpieczeństwie złożonym
W układzie 2oo2 dwa kanały wyznaczają to samo wyjście. Komparator (lub stopień wyjściowy) dopuszcza wyjście zezwalające tylko wtedy, gdy oba kanały są zgodne.
Pojedyncze uszkodzenie niebezpieczne ujawnia się jako niezgodność i system przechodzi w stan bezpieczny w czasie Td. Do zagrożenia potrzebne jest niebezpieczne uszkodzenie obu kanałów, przy czym drugie musi nastąpić, zanim pierwsze zostanie wykryte i zanegowane.
Założenia:
Oba kanały mają tę samą, stałą intensywność uszkodzeń niebezpiecznych λ (na godzinę).
Uszkodzenia obu kanałów są niezależne (wspólną przyczynę omawiam niżej osobno).
Każde uszkodzenie niebezpieczne jednego kanału zostaje wykryte i zanegowane w czasie Td.
λ·Td << 1.
Uproszczenie zachowawcze: każde drugie uszkodzenie niebezpieczne w czasie Td prowadzi do zagrożenia. W rzeczywistości oba kanały musiałyby dać to samo błędne wyjście, więc założenie jest pesymistyczne.
Wyprowadzenie:
Pierwsze uszkodzenie niebezpieczne w którymkolwiek kanale występuje z intensywnością 2λ.
Prawdopodobieństwo, że w oknie Td drugi kanał również ulegnie uszkodzeniu niebezpiecznemu, wynosi 1 − e^(−λ·Td) ≈ λ·Td.
Intensywność zagrożeń jest iloczynem obu wielkości.
Jeśli uszkodzenia ujawnia dopiero okresowy test co T, a nie ciągłe porównywanie, średni czas narażenia wynosi około T/2. Przyjęcie pełnego T jako Td jest wyborem zachowawczym.
Uszkodzenia spowodowane wspólną przyczyną.Uszkodzenie spowodowane wspólną przyczyną (CCF) dotyka obu kanałów naraz i daje w nich to samo błędne wyjście, więc komparator go nie widzi. Model współczynnika β zakłada, że ułamek β intensywności uszkodzeń niebezpiecznych każdego kanału ma wspólną przyczynę:
HR_total ≈ 2·λ²·Td + β·λ
Wz. 14 – Intensywność zagrożeń 2oo2 w modelu współczynnika β
Jak pokazuje przykład 3, składnik β·λ bardzo szybko zaczyna dominować. Dlatego EN 50129 wymaga, by układy o bezpieczeństwie złożonym wykazywały fizyczną i funkcjonalną niezależność kanałów, zamiast polegać na małym β w obliczeniach. Typowe środki to:
fizyczna separacja,
różnorodność (diversity),
niezależne zasilanie,
ochrona przed wspólnymi narażeniami środowiskowymi.
Przykłady obliczeń
Wszystkie wartości poniżej są przykładowe, dobrane tak, by rachunki dało się łatwo prześledzić. Nie pochodzą z żadnej bazy danych niezawodnościowych ani z rzeczywistego wyrobu.
Przykład 1: intensywność uszkodzeń pakietu z wartości FIT
Pakiet sterujący składa się z poniższych elementów, a do działania potrzebuje wszystkich (model szeregowy). Tabela podaje wartość FIT na sztukę i sumę w każdym wierszu:
Element
Liczba
FIT na szt.
FIT razem
Mikrokontroler
1
60
60
Przetwornica DC/DC
2
25
50
Zewnętrzna pamięć flash
1
20
20
Transceiver CAN
1
15
15
Generator kwarcowy
1
10
10
Złącza
1 kpl.
15
15
Elementy bierne (R, C)
80
0,5
40
Razem
210
λ = 210 FIT = 210 · 1e-9 /h = 2,1e-7 /hMTTF = 1 / 2,1e-7 /h ≈ 4,76e6 h ≈ 544 lata
Prz. 1, kroki 1–2 – Intensywność uszkodzeń i MTTF
To oczywiście nie jest czas życia. Wynik mówi tylko, że w okresie normalnej eksploatacji populacja pakietów ulega 2,1e-7 uszkodzenia na pakiet na godzinę.
Prz. 1, krok 3 – Niezawodność w ciągu roku (t = 8760 h)
N_uszk/rok = 1000 · 8760 h · 2,1e-7 /h ≈ 1,84
Prz. 1, krok 4 – Oczekiwana liczba uszkodzeń we flocie 1000 pakietów
Wynik
Przy 1000 pakietów pracujących w trybie ciągłym należy się spodziewać około 1,8 uszkodzenia rocznie. Z taką liczbą planista utrzymania może pracować. Z MTTF równym 544 lata – nie.
Przykład 2: gotowość a MTTR
Urządzenie przytorowe ma MTTF = 50 000 h. Porównujemy dwie koncepcje utrzymania:
A = 50 000 / (50 000 + 4) ≈ 0,99992U = 1 − A ≈ 8,0e-5przestój/rok = 8,0e-5 · 8760 h ≈ 0,70 h ≈ 42 min
Prz. 2, przypadek A – MTTR = 4 h (części zamienne na miejscu, przeszkolony personel)
A = 50 000 / (50 000 + 24) ≈ 0,99952U ≈ 4,8e-4przestój/rok = 4,8e-4 · 8760 h ≈ 4,2 h
Prz. 2, przypadek B – MTTR = 24 h (części w centralnym magazynie, z dojazdem)
Ten sam sprzęt, sześć razy dłuższy przestój. O gotowości często w równym stopniu decyduje koncepcja utrzymania, co sam projekt.
Przypadek C dotyczy redundancji. Dwa urządzenia w układzie 1oo2, każde z λ = 1e-4 /h (MTTF 10 000 h), MTTR = 8 h (μ = 0,125 /h):
Prz. 2, przypadek C – MTTF układu 1oo2 bez naprawy i z naprawą
Wynik
W porównaniu z jednym urządzeniem (10 000 h) redundancja bez naprawy daje 1,5 raza dłuższy MTTF. Z naprawą – ponad 600 razy dłuższy (6,27e6 h / 10 000 h ≈ 627), pod warunkiem że uszkodzenie jednego urządzenia zostanie wykryte i zgłoszone.
Przykład 3: układ 2oo2 o bezpieczeństwie złożonym
Dwa kanały, każdy o intensywności uszkodzeń niebezpiecznych λ = 1e-5 /h. Uszkodzenie niebezpieczne jednego kanału jest wykrywane przez porównanie krzyżowe i negowane w czasie Td = 1 h.
Krok 2 to porównanie z przedziałami SIL. 2,0e-10 /h to mniej niż 1e-9 /h, więc – biorąc pod uwagę wyłącznie losowe uszkodzenia sprzętu – układ spełniłby każdą dopuszczalną intensywność z przedziału SIL 4 (1e-9 ≤ intensywność < 1e-8).
Zapas wynosi 5 względem dolnej granicy przedziału i 50 względem górnej. Każdy kanał osobno (1e-5 /h) nie osiągnąłby nawet SIL 1.
Krok 3 to wrażliwość na Td. Intensywność zagrożeń rośnie liniowo z Td:
Td
HR (/h)
Na tle przedziału SIL 4
0,1 h (6 min)
2,0e-11
znacznie poniżej
1 h
2,0e-10
poniżej
10 h
2,0e-9
w przedziale SIL 4
24 h
4,8e-9
w przedziale SIL 4, mały zapas
100 h
2,0e-8
powyżej (przedział SIL 3)
Uszkodzenie, które przez kilka dni pozostaje niezauważone, niweczy korzyść z drugiego kanału. Szybkie i częste porównywanie oraz pewna, szybka ścieżka negacji są warte więcej niż lepszy element.
Krok 4 to wrażliwość na wspólną przyczynę. Tabela dodaje składnik CCF β·λ (Wz. 14) przy λ = 1e-5 /h i Td = 1 h:
β
β·λ (/h)
HR_total (/h)
0
0
2,0e-10
1e-5 (0,001%)
1,0e-10
3,0e-10
1e-4 (0,01%)
1,0e-9
1,2e-9
1e-3 (0,1%)
1,0e-8
1,02e-8
1e-2 (1%)
1,0e-7
1,0e-7
Aby HR_total pozostała poniżej 1e-9 /h, składnik CCF musi być mniejszy niż 1e-9 − 2e-10 = 8e-10 /h:
Uszkodzenia niezależne dają 2,0e-10 /h, ale żeby suma nie przekroczyła 1e-9 /h, β musi być mniejsze niż 8e-5.
To znacznie mniej niż wartości β powszechnie przyjmowane dla redundantnej elektroniki, które są rzędu procentów. Samo obliczenie ze współczynnikiem β nie doprowadzi układu 2oo2 do SIL 4.
Argumentacja musi opierać się na wykazanej niezależności kanałów i na wykrywaniu skutków wspólnych przyczyn (np. monitorowaniu wspólnego zasilania i temperatury).
Dopiero wtedy pozostałe niewykryte, identyczne uszkodzenia spowodowane wspólną przyczyną można wiarygodnie uznać za pomijalne.
Typowe błędy
W raportach RAMS ciągle powtarzają się te same błędy:
Traktowanie MTBF jako oczekiwanego czasu życia. MTBF równy 200 000 godzin nie znaczy, że urządzenie przetrwa 23 lata. W chwili t = MTBF uszkodzonych jest już około 63% egzemplarzy (o ile model wykładniczy w ogóle jeszcze obowiązuje).
Czas eksploatacji ogranicza zużycie, które modele ze stałą λ pomijają.
Mieszanie miar „na godzinę” i „na żądanie”. Kolejowe THR i TFFR wyraża się na godzinę. Funkcje IEC 61508 w trybie rzadkiego żądania opisuje PFD (prawdopodobieństwo uszkodzenia na żądanie), wielkość bezwymiarowa.
PFD równe 1e-4 nie jest porównywalne z intensywnością 1e-4 /h.
Nie łącz ich w jednym drzewie niezdatności bez przeliczenia przez częstość żądań i czas narażenia.
Pomijanie uszkodzeń spowodowanych wspólną przyczyną. Składnik 2λ²Td wygląda świetnie, ale – jak pokazuje przykład 3 – nawet bardzo małe β go niweczy.
Każde twierdzenie o architekturze redundantnej bez argumentacji CCF jest niepełne.
Mylenie THR z intensywnością uszkodzeń. THR to wymaganie dotyczące intensywności zagrożenia. Intensywność uszkodzeń to cecha obiektu.
Większość uszkodzeń jest bezpieczna, a intensywność zagrożeń zależy od architektury, diagnostyki i czasu wykrycia.
Pomijanie czasu wykrycia i negacji. Dwa kanały są lepsze od jednego tylko wtedy, gdy uszkodzenie pierwszego zostanie szybko wykryte i zanegowane.
Uszkodzenia ukryte, wychodzące na jaw dopiero przy kolejnym przeglądzie, zmieniają Td z sekund w miesiące.
Bezkrytyczne korzystanie z MIL-HDBK-217 (lub innego katalogu). Katalogi do prognozowania niezawodności służą do porównywania rozwiązań i jako punkt wyjścia, a nie jako pomiar tego, co dzieje się w eksploatacji.
MIL-HDBK-217F pochodzi z lat 90. i powszechnie uważa się, że dla współczesnych elementów daje wyniki pesymistyczne.
Inne źródła (warunki odniesienia IEC 61709, SN 29500, FIDES, dane eksploatacyjne dostawców) dają dla tego samego elementu różne wartości.
Niezależnie od źródła podaj je wraz z założeniami co do środowiska i temperatury i stosuj konsekwentnie.
Gdy tylko pojawią się dane o zwrotach z eksploatacji, porównaj z nimi wyniki.
Błędy jednostek. Najczęstsze pomyłki:
na godzinę czy na rok (współczynnik 8760),
FIT czy /h (współczynnik 1e9),
godziny pracy czy godziny kalendarzowe (pojazd jeżdżący 18 godzin na dobę),
na funkcję czy na system.
Stosowanie stałej λ tam, gdzie nie obowiązuje. Części mechaniczne, przekaźniki, akumulatory i oprogramowanie nie mają stałej intensywności uszkodzeń.
Jednostka przy każdej liczbie
W praktyce wiele błędnych wyników RAMS wynika z pomyłek w jednostkach, a nie w matematyce. Jednostkę trzeba pisać przy każdej liczbie w obliczeniach, a nie tylko przy wyniku końcowym.
Zestawienie wzorów
Tabela zbiera wzory użyte w artykule wraz z warunkami ich stosowania:
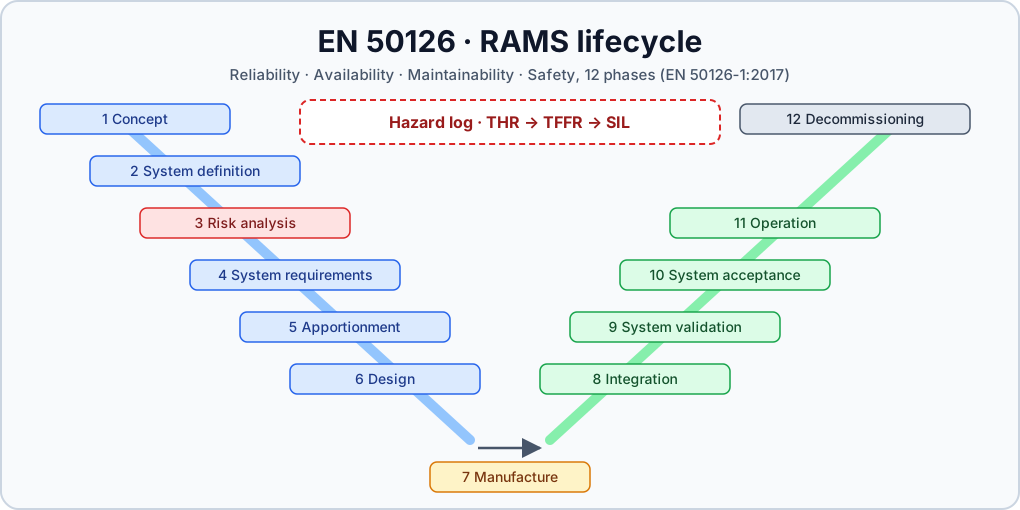
A practical guide to EN 50126-1/-2:2017: the 12-phase RAMS lifecycle, hazard log, CSM-RA-aligned risk acceptance, roles, independent safety assessment and THR/TFFR/SIL apportionment.Praktyczny przewodnik po EN 50126-1/-2:2017: 12-fazowy cykl życia systemu, rejestr zagrożeń, zasady akceptacji ryzyka zgodne z CSM-RA, role, niezależna ocena bezpieczeństwa oraz podział THR/TFFR/SIL.
How 2oo3 (TMR) voting works, how to design the voter, what happens after the first channel failure, and how 2oo3 compares with 2oo2 and 1oo2 using IEC 61508-6 PFD/PFH formulas.Jak działa głosowanie 2oo3 (TMR), jak zaprojektować układ głosujący, co się dzieje po pierwszym uszkodzeniu kanału i jak 2oo3 wypada na tle 2oo2 i 1oo2 według wzorów PFD/PFH z IEC 61508-6.
How 2oo2 composite fail-safe architectures work in railway signalling and safety computing: cross-checking, synchronisation, detection time, common-cause failures and the comparison with 2oo3.Jak działają architektury 2oo2 oparte na zasadzie bezpieczeństwa złożonego w urządzeniach srk: porównanie krzyżowe, synchronizacja, czas wykrycia, uszkodzenia spowodowane wspólną przyczyną i porównanie z 2oo3.