2oo3 Architecture: Triple Modular Redundancy for Safety and AvailabilityArchitektura 2oo3: potrójna redundancja modułowa dla bezpieczeństwa i dostępności
How 2oo3 (TMR) voting works, how to design the voter, what happens after the first channel failure, and how 2oo3 compares with 2oo2 and 1oo2 using IEC 61508-6 PFD/PFH formulas.Jak działa głosowanie 2oo3 (TMR), jak zaprojektować układ głosujący, co się dzieje po pierwszym uszkodzeniu kanału i jak 2oo3 wypada na tle 2oo2 i 1oo2 według wzorów PFD/PFH z IEC 61508-6.
Two-out-of-three (2oo3) voting, also called Triple Modular Redundancy (TMR), is the architecture you reach for when a safety-related function must be both safe and available.
Three channels compute the same function and a voter takes the majority. One faulty channel is outvoted, the system keeps running, and you get time to repair it.
In the 2oo2 architecture post I covered the two-channel case. This article covers 2oo3 and then compares the two properly.
That comparison is where many engineers go wrong, because “2oo2” means opposite things in the process industry and in railway signalling. For the reliability basics used below (λ, MTTR, hazard rates), see MTTF, MTBF and THR.
The 2oo3 Principle
In a 2oo3 architecture:
Three independent channels take the same inputs and run the same safety function.
A voter produces the output that at least two channels agree on.
One faulty channel is outvoted, and diagnostics identify and isolate it.
The system keeps operating in a degraded mode until that channel is repaired.
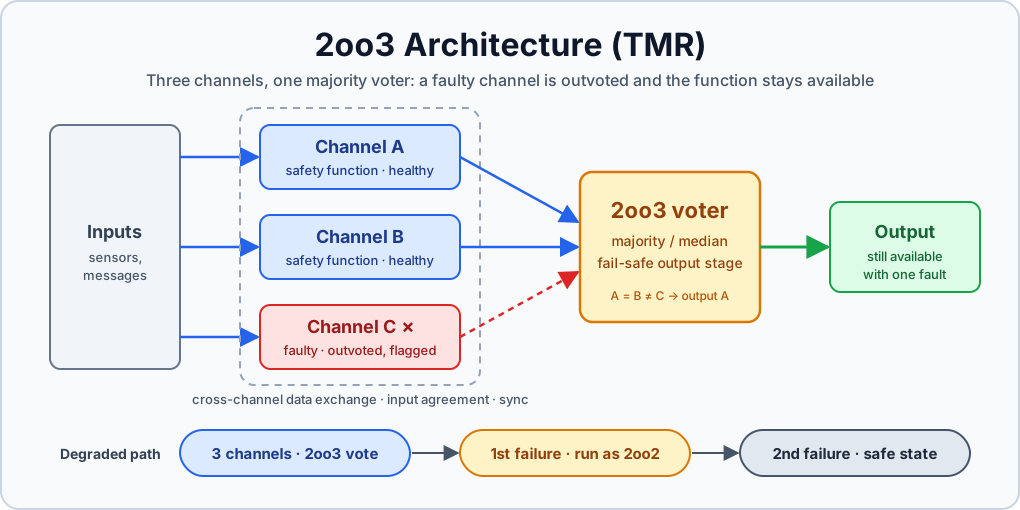
2oo3 architecture: one faulty channel is outvoted and the output stays available
The same structure as an ASCII sketch, including the cross-channel data exchange and the diagnostic path:
             +-----------+
  inputs --->| Channel A |---\
     |       +-----------+    \
     |       +-----------+     \   +-------------+
     +------>| Channel B |------+->|  2oo3 voter |---> output
     |       +-----------+     /   | (fail-safe) |
     |       +-----------+    /    +-------------+
     +------>| Channel C |---/            |
             +-----------+                v
                   ^              diagnostics: which
                   |              channel disagreed?
          cross-channel data exchange
          (input agreement, sync)
The three channels share the inputs, exchange data to agree on them, and feed a fail-safe voter. The voter also tells the diagnostics which channel disagreed, so that channel can be taken out of the vote.
Majority voting
Majority voting on a binary output is simple. The table shows representative combinations (the others are symmetric):
A
B
C
Output
Note
0
0
0
0
All agree
1
0
0
0
A outvoted, flagged as suspect
1
1
0
1
C outvoted, flagged as suspect
1
1
1
1
All agree
As a Boolean function, the 2oo3 majority is:
Out = (A · B) + (B · C) + (A · C)
Eq. 1 – 2oo3 majority function
For analogue values, the usual equivalent is mid-value selection (the median). A single channel that drifts high or low can never become the output.
Voter Design
The voter is where a 2oo3 design succeeds or fails. Three channels give you nothing if one simple voter can fail into a permissive state.
The voter as a single point of failure
Whatever produces the final output is common to all three channels. If it fails dangerously, the redundancy behind it does not matter.
Typical mitigations:
Voter in a safety-certified element. The voter is developed and assessed to the target SIL itself, not treated as “just glue logic”.
Fail-safe output stage. The output needs active, healthy signals to hold the permissive state, for example dynamic (pulsed) signals, charge pumps, or safety relays with forced-guided contacts. If the voter dies, the output drops to the safe state.
Distributed voting. Each channel reads the other two channels’ data and votes in software. The physical output is then voted again in hardware, for example by a series/parallel arrangement of output switches that energises only when two of three channels command it.
Voting at several stages. A fault is caught as close to its source as possible:
inputs are voted (or median-selected) before processing
intermediate results are exchanged and compared
outputs are voted
One voter, zero fault tolerance
If the final voter is a single non-fail-safe element, the hardware fault tolerance of the whole function is 0, no matter how many channels sit behind it.
Hardware vs software voting
The two voter types are complementary rather than competing:
Aspect
Hardware voter
Software voter (in each channel)
Complexity
Low, analysable with FMEA
Higher, needs software safety lifecycle
Flexibility
Fixed logic
Can vote on messages, analogue values, time-stamped data
In practice, mature platforms combine both: software voting for data and diagnostics, and a simple fail-safe hardware stage for the final actuation.
Behaviour on First Channel Failure
This is the main reason to pay for a third channel.
2oo3: One channel fails and is outvoted, and diagnostics take it out of the vote. The system keeps running on the two remaining channels, so availability is preserved.
2oo2 (railway, fail-safe sense): One channel fails and the two channels no longer agree. The system cannot tell which channel is right, so it goes to the safe state: safe, but the function is now unavailable.
What the remaining pair does after a 2oo3 system degrades is a design decision:
Degraded mode
Rule
Typical context
Effect
2oo2 (agreement required)
Both remaining channels must agree before any permissive output
Railway composite fail-safe computing
Safety kept; a second failure forces the safe state
1oo2 (either can trip)
Either remaining channel can initiate the trip
Process safety, safety has priority
Safety kept; more spurious trips
2oo2 (both must trip)
Both remaining channels must vote to trip
Process safety, availability has priority
Safety reduced during the degraded period
The common pattern is 3-2-0: three channels, then two, then a safe shutdown.
Some platforms allow 3-2-1-0 operation. Running safety-critical functions on one channel, however, needs strong self-diagnostics and usually a strict time limit.
Degraded-mode repair time
While the system runs on two channels, it has lost its fault tolerance, so the time spent in that state counts directly toward risk:
Specify a maximum degraded-mode duration in the safety requirements, and consider an automatic shutdown or restriction when it expires.
Make the failed channel visible to maintenance through alarms and event logs.
Base the reliability calculations on a realistic MTTR/MRT, not an optimistic one. The IEC 61508-6 formulas include repair time for exactly this reason.
The silent degraded state
A degraded state that nobody notices is the classic way TMR systems lose their margin. The system looks healthy from the outside while it is really running as 2oo2, without any fault tolerance left.
Safety vs Availability
Every voting architecture splits failures into two kinds:
Dangerous failures, where the safety function does not act when it should. They are measured as PFDavg (low demand) or PFH (high or continuous demand).
Safe (spurious) failures, where the function acts when it should not, for example a spurious trip, a train brought to a stop, or a plant shut down. They are measured as a spurious trip rate.
Two-channel architectures trade one against the other. 2oo3 is the architecture that improves both at the same time, at the cost of more hardware and a more complex voter.
Common-Cause Failures and the Beta Factor
Redundancy only helps against independent failures. A common-cause failure (CCF) takes out several channels at once. Typical causes are:
a shared power supply problem
overheating
an EMC event
a software defect present in all three channels
a wrong calibration applied to all of them
IEC 61508-6 models this with the beta factor (β): the fraction of a channel’s failures assumed to affect all channels together.
Annex D of IEC 61508-6 gives a scoring method that derives β from design measures such as separation, diversity, environmental control, and competence. The resulting values are typically a few percent.
λ_DU,CCF = β · λ_DU (affects all channels at once)λ_DU,ind = (1 − β) · λ_DU (affects one channel)
Eq. 2 – Beta-factor split of a channel's dangerous undetected failure rate
Important
In well-designed redundant systems the β term often dominates the result. Adding a third channel reduces the independent-failure term, but it does nothing for the CCF term. The worked example shows this with numbers.
Diversity
Diversity is the main way to reduce β:
Hardware diversity: different processor families, different suppliers, different board designs.
Software diversity: different compilers, independently developed versions, or diverse data representations, such as one channel computing on inverted or coded data.
Temporal diversity: channels deliberately offset in time, so that a short disturbance does not hit all of them in the same state.
Physical separation: separate housings, power feeds, and cable routes.
Full N-version software is expensive and its independence is limited, because teams working from the same specification tend to make correlated mistakes.
Many platforms therefore use identical software on diverse or diagnostically strong hardware. They put their effort into a rigorous software lifecycle (for railway, EN 50128 / EN 50716) to control systematic faults.
Synchronisation and Input Agreement
Three channels that sample the world at slightly different instants will see slightly different inputs. If you don’t design for that, a perfectly healthy system will vote against itself.
Synchronisation
The three common synchronisation schemes trade ease of comparison against flexibility:
Scheme
How it works
Trade-off
Lockstep
Channels execute the same instruction on the same clock
Easy comparison, but tight coupling makes diversity hard
Loosely synchronised (cycle-based)
Each channel runs its own clock and synchronises at the start or end of each processing cycle by exchanging data
Most common approach in railway and process platforms
Asynchronous, time-stamped data
Channels run freely and data carries time stamps
Most flexible, hardest to analyse
Input agreement
Before processing, the channels exchange their raw input readings and agree on a common input set. Without this step, two healthy channels can produce different outputs from slightly different inputs.
Discrete inputs: majority vote, plus a discrepancy timer that tolerates short disagreements caused by contact bounce or sampling skew, then flags a fault.
Analogue inputs: median selection, plus a tolerance window. A channel that stays outside the window for longer than the discrepancy time is declared faulty.
Sizing the tolerance window
If the window is too tight, you get nuisance faults from sensor tolerance and timing skew. If it is too loose, a drifting channel is masked while it degrades. Size it from the sensor accuracy and the worst-case sampling skew, not from what “looks reasonable”.
A note on Byzantine faults
A faulty channel that sends different values to different peers is called a Byzantine fault.
Classic results from distributed computing (Lamport, Shostak and Pease) show that tolerating f such faults with plain (unsigned) message exchange requires a minimum number of nodes:
N ≥ 3f + 1f = 1 → N ≥ 4
Eq. 3 – Nodes needed to tolerate f Byzantine faults (unsigned messages)
Three channels are therefore not enough to tolerate one Byzantine fault in the data exchange itself. Practical 2oo3 platforms address this through:
broadcast buses, where every receiver sees the same message
message authentication or CRC with sender identity
treating any inconsistency in the exchange as a detected fault that leads to the safe state, not as something to vote away
Diagnostics
The vote tells you that a channel disagrees. Diagnostics tell you why, and they catch faults that voting would hide:
Latent faults: a channel whose output stage is stuck in the safe state is outvoted silently, and you have a hidden 2oo2 system. Periodic output tests and readback are essential.
Cross-channel comparison of intermediate results, CRCs of configuration data, and memory checksums.
Self-tests: CPU, RAM, ROM, watchdogs, and clock monitoring.
Proof tests at interval T1 for faults that online diagnostics cannot detect.
Diagnostic coverage (DC) splits each channel’s dangerous failure rate into a detected and an undetected part, and therefore feeds every formula below:
λ_DD = DC · λ_Dλ_DU = (1 − DC) · λ_D
Eq. 4 – Detected and undetected dangerous failure rates
2oo3 vs 2oo2: The Comparison That Matters
Two meanings of “2oo2”
This is the most common source of confusion in reviews and audits.
Process industry (IEC 61508 / IEC 61511) notation: MooN describes how many channels must demand the trip (the safe action). The usual de-energise-to-trip convention applies.
2oo2 means both channels must vote to trip. One dangerous channel failure (the channel cannot trip) defeats the function. Safety is low and spurious trips are rare.
1oo2 means either channel can trip. Both channels must fail dangerously to defeat the function. Safety is high and spurious trips are more frequent.
Railway / composite fail-safe computing notation (EN 50126/50128/50129 context): “2oo2” describes how many channels must agree before any output is produced.
A permissive output, such as a proceed aspect, a movement authority, or a point command, is produced only when both channels agree. Any disagreement leads to the safe state.
From the hazard perspective, both channels must fail in the same wrong way for a dangerous output to appear. Either channel alone can force the safe state.
In process terminology, this is closer to 1oo2 for safety and 2oo2 for availability (both channels must be healthy for the system to run).
So the railway 2oo2 gives high safety and low availability.
Same symbols, opposite characteristics
When you read a reliability figure for a “2oo2” system, first check which action the “2” refers to: the trip, or the permissive output.
For the rest of this section:
“2oo2 (process)” is 2oo2 in the IEC 61508-6 sense: both must vote to trip.
“2oo2 (fail-safe)” is the railway composite fail-safe sense, which behaves like 1oo2 on safety.
1oo2D, 2oo2D and related variants
1oo2D: a 1oo2 architecture with diagnostics. A detected fault in one channel takes it out and the other continues in 1oo1, which improves availability compared with plain 1oo2. It is one of the architectures tabulated in IEC 61508-6.
2oo2D: a 2oo2 architecture with diagnostics that can take a channel with a detected fault out, so the system continues on the healthy one. It is not part of the IEC 61508-6 formula set.
2×2oo2: two 2oo2 (fail-safe) units in hot standby, the railway’s other common answer to the availability problem of 2oo2 (fail-safe). It gives TMR-like availability through redundant fail-safe pairs instead of majority voting.
2oo2D appears in the safety PLC reliability literature and in vendor documentation, and the definitions vary. Check the definition each author uses before you compare numbers.
Simplified IEC 61508-6 formulas
IEC 61508-6 Annex B gives PFD and PFH equations for 1oo1, 1oo2, 2oo2, 1oo2D and 2oo3. They include diagnostic coverage, repair times and separate β factors for detected and undetected failures.
The simplified forms below follow from those equations under these assumptions.
Assumptions behind the simplified formulas
identical channels with dangerous undetected failure rate λDU per channel
no online diagnostics (λDD = 0), so all dangerous failures are found only by the proof test
perfect proof test at interval T1
repair time MRT/MTTR ≪ T1
the (1 − β) factors on the independent terms are approximated as 1, which is slightly conservative
β is the common-cause fraction for undetected dangerous failures
process (trip-demand) notation for 1oo2 and 2oo2
Low demand mode, average probability of failure on demand (PFDavg). The table summarises the four architectures, and the formula block gives the same equations in full:
Eq. 5 – Simplified PFDavg, no diagnostics (from IEC 61508-6, Annex B)
Where these come from: in IEC 61508-6, with no diagnostics and MRT ≪ T1, the channel-equivalent mean down time is tCE ≈ T1/2 and the system-equivalent down time is tGE ≈ T1/3. Substituting gives the independent terms:
Eq. 6 – Independent terms from the IEC 61508-6 equations
The factor 6 for 2oo3 against 2 for 1oo2 reflects that three channels form three pairs, and any pair failing defeats the function. For 2oo2 (process), two channels each defeat the function alone, so the single-channel term is doubled.
High demand / continuous mode, average frequency of dangerous failure (PFH):
Eq. 7 – Simplified PFH, no diagnostics (from IEC 61508-6, Annex B)
These use tCE ≈ T1/2 and are a first-order approximation.
Not for SIL verification. For real SIL verification, use the full IEC 61508-6 equations with your actual λDD, diagnostic coverage, βD and MRT, or a Markov or fault tree model. The simplified forms are for understanding and quick comparison only.
The railway view. Railway safety cases under EN 50129 typically argue the hazard rate of a fail-safe composite through two times:
detection time: how quickly a disagreement or diagnostic fault is detected
negation time: how quickly the safe state is reached
The mathematical structure is the same idea: dangerous outcomes need a second, coincident failure within a window. The arguments are just framed differently from the IEC 61508-6 tables.
Spurious trip rate (safe failures)
Let λS be the safe failure rate per channel, meaning a failure that causes the channel to demand a trip. Assume a channel that trips spuriously is detected and repaired within MTTR. Then, to first order:
1oo2 trips on any single safe failure. 2oo2 (process) and 2oo3 need two coincident safe failures, or a common-cause one.
For 2oo3 the first safe failure occurs at rate 3 · λS, and one of the two remaining channels must then fail within MTTR (2 · λS · MTTR), which gives the factor 6.
That is why 2oo2 (process) has the lowest spurious trip rate and the worst safety. It is also why 2oo3 gets close to 2oo2 on spurious trips while staying close to 1oo2 on safety.
Worked example
The numbers below are illustrative, chosen only to show how the terms compare. They are not data from any real product. The inputs are:
Parameter
Value
λDU per channel
1 × 10⁻⁶ /h
Proof test interval T1
1 year = 8760 h
β
5% (0.05)
λS per channel
5 × 10⁻⁶ /h
MTTR
8 h
The two quantities that appear in every PFDavg term are:
PFDavg. The table below splits each result into its independent and CCF term:
Architecture
Independent term
CCF term
PFDavg
Low-demand SIL band (PFD only)
1oo1
4.38 × 10⁻³
—
4.4 × 10⁻³
SIL 2
2oo2 (process)
8.76 × 10⁻³
—
8.8 × 10⁻³
SIL 2 (worse than 1oo1)
1oo2
2.56 × 10⁻⁵
2.19 × 10⁻⁴
2.4 × 10⁻⁴
SIL 3
2oo3
7.67 × 10⁻⁵
2.19 × 10⁻⁴
3.0 × 10⁻⁴
SIL 3
In 1oo2 and 2oo3, the CCF term is about 3 to 9 times larger than the independent term. Repeat the calculation with β = 1% and the CCF term drops to 4.38 × 10⁻⁵:
Once you have redundancy, reducing β is the most effective lever. It improves 1oo2 by a factor of about 3.5.
A third channel does not improve PFDavg at all. 2oo3 is slightly worse than 1oo2, because it has three channel pairs that can fail instead of one.
What the third channel buys is availability, as the spurious trip numbers show.
PFD is not the whole SIL story
The SIL bands above cover PFD only. The achievable SIL is also limited by architectural constraints (hardware fault tolerance and safe failure fraction) and by systematic capability.
Spurious trip rate. With λS = 5 × 10⁻⁶ /h and MTTR = 8 h:
Architecture
Rate (/h)
Approx. per year
Roughly one trip every
1oo1
5 × 10⁻⁶
0.044
23 years
1oo2
1 × 10⁻⁵
0.088
11 years
2oo2 (process)
4 × 10⁻¹⁰ + 2.5 × 10⁻⁷ ≈ 2.5 × 10⁻⁷
0.0022
460 years
2oo3
1.2 × 10⁻⁹ + 2.5 × 10⁻⁷ ≈ 2.5 × 10⁻⁷
0.0022
460 years
Again, common cause dominates. With these numbers, 2oo3 matches 2oo2 (process) on spurious trips and stays close to 1oo2 on safety. That combination is why TMR exists.
Comparison table
The table puts the three behaviours side by side:
Criterion
1oo2 (process) / 2oo2 (fail-safe)
2oo2 (process)
2oo3
Safety (dangerous failure)
High: needs two dangerous failures
Low: one dangerous failure defeats it
High: needs two dangerous failures
Availability / spurious trips
Low: any single fault trips or goes safe
High: needs two safe failures
High: needs two safe failures
Behaviour after 1st failure
Safe state (fail-safe) or trip (1oo2); 1oo2D can continue as 1oo1
A safe failure leaves it running as 1oo1; a dangerous one defeats the function
Outvotes the faulty channel, continues as 2oo2 / 1oo2 in degraded mode
Hardware
2 channels + comparator
2 channels + AND/OR logic
3 channels + majority voter + data exchange
Cost and complexity
Medium
Medium
High: voter, synchronisation, input agreement
CCF sensitivity
β term often dominates
Low relevance (already single-failure sensitive)
β term often dominates
Hardware fault tolerance (dangerous)
1
0
1
Typical use
Railway fail-safe computers, emergency shutdown where trips are acceptable
Where spurious trips are very costly and the SIL target is modest
Functions that must be both highly safe and highly available
Typical Domains
Railway signalling
Electronic interlockings and RBC platforms typically need SIL 4 for their safety functions. They also need very high availability, because a safe shutdown stops traffic over a whole area.
Platforms in the field broadly follow two patterns, described here only in general terms:
2oo3 composite fail-safe computers, which degrade to 2oo2 after the first channel failure
2×2oo2: a duplicated fail-safe pair with switchover
Both target the same goal: SIL 4 safety from fail-safe agreement, and availability from a third channel or a standby pair.
Which one fits is a system-level decision that depends on maintenance concept, switchover behaviour, and lifecycle cost. The hazard and SIL allocation behind that decision comes from the EN 50126 RAMS process.
Process industry (IEC 61508 / IEC 61511)
TMR safety PLCs have been used in safety instrumented systems for decades, for example in emergency shutdown, burner management, and fire and gas systems.
Field devices are often configured 2oo3 as well, for example three pressure transmitters with median selection. Spurious trips in a large plant are expensive and can themselves create hazards during shutdown and restart.
Avionics flight control
The publicly documented Boeing 777 primary flight control system is a well-known example of triple redundancy. It uses three primary flight computers, and each of them contains three internal lanes built on dissimilar processors.
Redundancy management combines cross-lane and cross-computer comparison with dissimilarity to address both random and common-cause failures.
Other aircraft families rely more on command/monitor pairs plus dissimilar backup computers. That is a reminder that TMR is one option among several, not the only route to high integrity.
Design Checklist
Is the voter developed to the target SIL, and does it fail to the safe state?
Are latent faults (a channel stuck in the safe state, a silently outvoted channel) detected by periodic tests?
Is input agreement defined: tolerance windows, discrepancy timers, and sampling skew?
Is the data exchange protected against inconsistent (Byzantine) messages?
Is the degraded-mode behaviour (2oo2, 1oo2, or shutdown) specified and justified?
Is the maximum degraded-mode duration specified and enforced?
Has β been derived systematically (for example with IEC 61508-6 Annex D), not just assumed?
When you quote “2oo2”, is it clear whether the “2” refers to the trip or to the permissive output?
L. Lamport, R. Shostak, M. Pease, “The Byzantine Generals Problem”, ACM TOPLAS, 1982
Głosowanie „dwa z trzech” (2oo3), nazywane też potrójną redundancją modułową (TMR, Triple Modular Redundancy), to architektura, po którą sięga się wtedy, gdy funkcja związana z bezpieczeństwem ma być jednocześnie bezpieczna i dostępna.
Trzy kanały realizują tę samą funkcję, a układ głosujący wybiera wynik większości. Uszkodzony kanał zostaje przegłosowany, system pracuje dalej i jest czas na naprawę.
W artykule o architekturze 2oo2 opisałem przypadek dwukanałowy. Tutaj zajmuję się architekturą 2oo3, a potem rzetelnie porównuję obie.
Właśnie na tym porównaniu wielu inżynierów się potyka, bo „2oo2” oznacza coś odwrotnego w przemyśle procesowym i w sterowaniu ruchem kolejowym. Podstawy niezawodności, z których korzystam poniżej (λ, MTTR, intensywność zagrożeń), omówiłem w artykule MTTF, MTBF i THR.
Zasada działania 2oo3
W architekturze 2oo3:
Trzy niezależne kanały dostają te same wejścia i realizują tę samą funkcję bezpieczeństwa.
Układ głosujący (voter) wystawia wynik, co do którego zgadzają się co najmniej dwa kanały.
Jeden uszkodzony kanał zostaje przegłosowany, a diagnostyka go wskazuje i izoluje.
System pracuje dalej w trybie zdegradowanym, dopóki ten kanał nie zostanie naprawiony.
Architektura 2oo3: jeden uszkodzony kanał zostaje przegłosowany, a wyjście pozostaje dostępne
Ta sama struktura w postaci szkicu ASCII, z wymianą danych między kanałami i ścieżką diagnostyczną:
             +-----------+
 wejścia --->|  Kanał A  |---\
     |       +-----------+    \
     |       +-----------+     \   +-----------------+
     +------>|  Kanał B  |------+->| układ głosujący |---> wyjście
     |       +-----------+     /   | 2oo3, fail-safe |
     |       +-----------+    /    +-----------------+
     +------>|  Kanał C  |---/              |
             +-----------+                  v
                   ^              diagnostyka: który kanał
                   |              się nie zgadza?
          wymiana danych między kanałami
          (uzgadnianie wejść, synchronizacja)
Kanały mają wspólne wejścia, wymieniają dane, żeby uzgodnić ich wartości, i przekazują wyniki do układu głosującego typu fail-safe. Układ głosujący informuje też diagnostykę, który kanał się nie zgadza – dzięki temu można go wyłączyć z głosowania.
Głosowanie większościowe
Dla wyjścia dwustanowego głosowanie większościowe jest proste. Tabela pokazuje reprezentatywne kombinacje (pozostałe są symetryczne):
A
B
C
Wyjście
Uwagi
0
0
0
0
Wszystkie zgodne
1
0
0
0
A przegłosowany, oznaczony jako podejrzany
1
1
0
1
C przegłosowany, oznaczony jako podejrzany
1
1
1
1
Wszystkie zgodne
Zapisana jako funkcja logiczna, większość 2oo3 wygląda tak:
Out = (A · B) + (B · C) + (A · C)
Wzór 1 – Funkcja większościowa 2oo3
Dla wartości analogowych odpowiednikiem jest zwykle wybór wartości środkowej (mediany). Pojedynczy kanał, który odpłynie w górę lub w dół, nigdy nie trafi na wyjście.
Projekt układu głosującego
Od układu głosującego zależy, czy projekt 2oo3 się obroni. Trzy kanały nic nie dają, jeśli jeden prosty układ głosujący może się uszkodzić w stanie zezwalającym.
Układ głosujący jako pojedynczy punkt uszkodzenia
Element, który wytwarza końcowe wyjście, jest wspólny dla wszystkich trzech kanałów. Jeśli ulegnie uszkodzeniu niebezpiecznemu, cała redundancja przed nim traci znaczenie.
Typowe środki zaradcze:
Układ głosujący w elemencie certyfikowanym na potrzeby bezpieczeństwa. Sam układ głosujący jest opracowany i oceniony na docelowy SIL, a nie traktowany jak „zwykła logika sklejająca”.
Stopień wyjściowy typu fail-safe. Stan zezwalający utrzymuje się tylko dzięki aktywnym, poprawnym sygnałom, np. sygnałom dynamicznym (impulsowym), pompom ładunkowym albo przekaźnikom bezpieczeństwa o stykach wymuszonych. Gdy układ głosujący przestaje działać, wyjście przechodzi w stan bezpieczny.
Głosowanie rozproszone. Każdy kanał odczytuje dane dwóch pozostałych i głosuje programowo. Fizyczne wyjście jest następnie głosowane jeszcze raz sprzętowo, np. przez szeregowo-równoległy układ łączników, który załącza odbiornik tylko wtedy, gdy wysterują go dwa z trzech kanałów.
Głosowanie na kilku etapach. Uszkodzenie zostaje wykryte jak najbliżej źródła:
wejścia są głosowane (albo wybierana jest mediana) przed przetwarzaniem
wyniki pośrednie są wymieniane i porównywane
wyjścia są głosowane
Jeden układ głosujący, zerowa tolerancja uszkodzeń
Jeśli końcowy układ głosujący to pojedynczy element, który nie jest typu fail-safe, tolerancja uszkodzeń sprzętu całej funkcji wynosi 0 – bez względu na to, ile kanałów stoi przed nim.
Głosowanie sprzętowe a programowe
Oba rodzaje układów głosujących się uzupełniają, a nie konkurują:
Aspekt
Sprzętowy układ głosujący
Programowy układ głosujący (w każdym kanale)
Złożoność
Niska, daje się przeanalizować metodą FMEA
Większa, wymaga cyklu życia oprogramowania związanego z bezpieczeństwem
Elastyczność
Stała logika
Głosowanie nad komunikatami, wartościami analogowymi, danymi ze znacznikiem czasu
Rodzaje uszkodzeń
Dobrze poznane (zablokowanie, zwarcie, przerwa)
Uszkodzenia systematyczne, zależności czasowe, przekłamanie danych
Typowe zastosowanie
Końcowy stopień wyjściowy
Uzgadnianie wejść, wyniki pośrednie, diagnostyka
W praktyce dojrzałe platformy łączą oba podejścia: głosowanie programowe dla danych i diagnostyki oraz prosty sprzętowy stopień fail-safe do końcowego wysterowania.
Zachowanie po pierwszym uszkodzeniu kanału
To główny powód, dla którego warto płacić za trzeci kanał.
2oo3: jeden kanał się psuje i zostaje przegłosowany, a diagnostyka wyłącza go z głosowania. System pracuje dalej na dwóch pozostałych kanałach, więc dostępność zostaje zachowana.
2oo2 (kolejowe, w sensie fail-safe): jeden kanał się psuje i kanały przestają być zgodne. System nie wie, który z nich ma rację, więc przechodzi w stan bezpieczny – to bezpieczne, ale funkcja przestaje być dostępna.
To, jak zachowuje się pozostała para kanałów po degradacji systemu 2oo3, jest decyzją projektową:
Tryb zdegradowany
Reguła
Typowy kontekst
Skutek
2oo2 (wymagana zgodność)
Oba pozostałe kanały muszą się zgodzić, zanim pojawi się wyjście zezwalające
Bezpieczeństwo zachowane; drugie uszkodzenie wymusza stan bezpieczny
1oo2 (każdy może wyzwolić)
Każdy z pozostałych kanałów może zainicjować wyzwolenie
Przemysł procesowy, priorytet ma bezpieczeństwo
Bezpieczeństwo zachowane; więcej fałszywych zadziałań
2oo2 (oba muszą wyzwolić)
Oba pozostałe kanały muszą zagłosować za wyzwoleniem
Przemysł procesowy, priorytet ma dostępność
Bezpieczeństwo obniżone na czas degradacji
Typowy schemat to 3-2-0: trzy kanały, potem dwa, potem bezpieczne wyłączenie.
Niektóre platformy dopuszczają pracę w schemacie 3-2-1-0. Realizacja funkcji krytycznych dla bezpieczeństwa na jednym kanale wymaga jednak silnej autodiagnostyki i zwykle ścisłego limitu czasu.
Czas naprawy w trybie zdegradowanym
Na dwóch kanałach system nie ma już tolerancji uszkodzeń, więc każda godzina w tym stanie wprost przekłada się na ryzyko:
Określ w wymaganiach bezpieczeństwa maksymalny czas pracy w trybie zdegradowanym i rozważ automatyczne wyłączenie lub ograniczenie funkcji po jego przekroczeniu.
Zadbaj o to, żeby uszkodzony kanał był widoczny dla służb utrzymania – przez alarmy i rejestr zdarzeń.
Przyjmuj w obliczeniach niezawodności realistyczny MTTR/MRT, a nie optymistyczny. Właśnie dlatego wzory z IEC 61508-6 uwzględniają czas naprawy.
Niezauważony stan zdegradowany
Stan zdegradowany, którego nikt nie zauważa, to klasyczna droga, którą systemy TMR tracą swój zapas. Z zewnątrz system wygląda na sprawny, a w rzeczywistości pracuje jako 2oo2, bez żadnej tolerancji uszkodzeń.
Bezpieczeństwo a dostępność
Każda architektura z głosowaniem dzieli uszkodzenia na dwa rodzaje:
Uszkodzenia niebezpieczne – funkcja bezpieczeństwa nie działa wtedy, gdy powinna. Miarą jest PFDavg (tryb małego zapotrzebowania) albo PFH (tryb dużego zapotrzebowania lub ciągły).
Uszkodzenia bezpieczne (fałszywe zadziałania) – funkcja działa wtedy, gdy nie powinna, np. fałszywe wyzwolenie, zatrzymanie pociągu czy wyłączenie instalacji. Miarą jest częstość fałszywych zadziałań.
Architektury dwukanałowe poprawiają jedno kosztem drugiego. 2oo3 poprawia oba parametry naraz, za cenę większej ilości sprzętu i bardziej złożonego układu głosującego.
Uszkodzenia spowodowane wspólną przyczyną i współczynnik beta
Redundancja chroni tylko przed uszkodzeniami niezależnymi. Uszkodzenie spowodowane wspólną przyczyną (CCF, common cause failure) wyłącza kilka kanałów naraz. Typowe przyczyny to:
awaria wspólnego zasilania
przegrzanie
zaburzenie elektromagnetyczne (EMC)
błąd oprogramowania obecny we wszystkich trzech kanałach
błędna kalibracja wprowadzona do wszystkich kanałów
IEC 61508-6 modeluje to zjawisko współczynnikiem beta (β), czyli tą częścią uszkodzeń kanału, o której zakłada się, że dotyka wszystkich kanałów jednocześnie.
Załącznik D normy IEC 61508-6 podaje metodę punktową, która wyznacza β na podstawie zastosowanych środków projektowych, takich jak separacja, różnorodność, kontrola warunków środowiskowych i kompetencje. Wychodzą z niej zwykle wartości rzędu kilku procent.
λ_DU,CCF = β · λ_DU (dotyczy wszystkich kanałów naraz)λ_DU,ind = (1 − β) · λ_DU (dotyczy jednego kanału)
Wzór 2 – Podział intensywności niebezpiecznych niewykrytych uszkodzeń kanału według współczynnika beta
Important
W dobrze zaprojektowanych systemach redundantnych to składnik β często przesądza o wyniku. Trzeci kanał zmniejsza składnik uszkodzeń niezależnych, ale składnika CCF nie zmienia wcale. Przykład obliczeniowy w dalszej części pokazuje to na liczbach.
Różnorodność
Różnorodność to główny sposób na zmniejszenie β:
Różnorodność sprzętowa: różne rodziny procesorów, różni dostawcy, różne projekty płytek.
Różnorodność programowa: różne kompilatory, niezależnie opracowane wersje albo różne reprezentacje danych, np. jeden kanał liczy na danych zanegowanych lub kodowanych.
Różnorodność czasowa: kanały celowo przesunięte w czasie, żeby krótkie zakłócenie nie trafiło wszystkich w tym samym stanie.
Separacja fizyczna: oddzielne obudowy, zasilania i trasy kablowe.
Pełne oprogramowanie N-wersyjne jest drogie, a jego niezależność ograniczona – zespoły pracujące według tej samej specyfikacji popełniają podobne błędy.
Dlatego wiele platform stosuje identyczne oprogramowanie na zróżnicowanym albo silnie diagnozowanym sprzęcie. Wysiłek idzie wtedy w rygorystyczny cykl życia oprogramowania (na kolei według EN 50128 / EN 50716), który ma panować nad uszkodzeniami systematycznymi.
Synchronizacja i uzgadnianie wejść
Trzy kanały, które próbkują otoczenie w nieco innych chwilach, widzą nieco inne wejścia. Jeśli projekt tego nie uwzględnia, w pełni sprawny system zacznie głosować sam przeciw sobie.
Synchronizacja
Trzy typowe schematy synchronizacji to kompromis między łatwością porównywania a elastycznością:
Schemat
Zasada działania
Kompromis
Lockstep
Kanały wykonują tę samą instrukcję w tym samym takcie zegara
Łatwe porównywanie, ale ścisłe sprzężenie utrudnia różnorodność
Luźna synchronizacja (cykliczna)
Każdy kanał ma własny zegar i synchronizuje się przez wymianę danych na początku lub końcu cyklu przetwarzania
Najczęstsze rozwiązanie w platformach kolejowych i procesowych
Praca asynchroniczna, dane ze znacznikiem czasu
Kanały pracują swobodnie, a dane niosą znaczniki czasu
Największa elastyczność, najtrudniejsza analiza
Uzgadnianie wejść
Przed przetwarzaniem kanały wymieniają surowe odczyty wejść i uzgadniają wspólny zestaw danych wejściowych. Bez tego kroku dwa sprawne kanały mogą dać różne wyjścia z minimalnie różnych wejść.
Wejścia dwustanowe: głosowanie większościowe plus licznik czasu rozbieżności, który toleruje krótkie niezgodności (drgania styków, przesunięcie próbkowania), a po jego upływie zgłasza uszkodzenie.
Wejścia analogowe: wybór mediany plus okno tolerancji. Kanał, który pozostaje poza oknem dłużej niż dopuszczalny czas rozbieżności, zostaje uznany za uszkodzony.
Dobór okna tolerancji
Za wąskie okno generuje uciążliwe zgłoszenia uszkodzeń wynikające z tolerancji czujników i przesunięć czasowych. Za szerokie maskuje kanał, który powoli odpływa. Okno dobiera się na podstawie dokładności czujnika i najgorszego przypadku przesunięcia próbkowania, a nie tego, co „wygląda rozsądnie”.
Uwaga o uszkodzeniach bizantyjskich
Uszkodzony kanał, który wysyła różne wartości do różnych odbiorców, to przypadek uszkodzenia bizantyjskiego (Byzantine fault).
Klasyczne wyniki z teorii systemów rozproszonych (Lamport, Shostak i Pease) pokazują, że do tolerowania f takich uszkodzeń przy zwykłej (niepodpisanej) wymianie komunikatów potrzeba minimalnej liczby węzłów:
N ≥ 3f + 1f = 1 → N ≥ 4
Wzór 3 – Liczba węzłów potrzebna do tolerowania f uszkodzeń bizantyjskich (komunikaty niepodpisane)
Trzy kanały nie wystarczą więc, żeby tolerować jedno uszkodzenie bizantyjskie w samej wymianie danych. Praktyczne platformy 2oo3 radzą sobie z tym przez:
magistrale rozgłoszeniowe, na których każdy odbiorca widzi ten sam komunikat
uwierzytelnianie komunikatów albo CRC z identyfikatorem nadawcy
traktowanie każdej niespójności w wymianie jako wykrytego uszkodzenia, które prowadzi do stanu bezpiecznego, a nie jako czegoś, co da się przegłosować
Diagnostyka
Głosowanie mówi tylko, że kanał się nie zgadza. Diagnostyka mówi dlaczego i wykrywa uszkodzenia, które głosowanie by ukryło:
Uszkodzenia ukryte: kanał, którego stopień wyjściowy zablokował się w stanie bezpiecznym, jest po cichu przegłosowywany – w praktyce działa wtedy ukryty system 2oo2. Niezbędne są okresowe testy wyjść i odczyt zwrotny.
Porównywanie międzykanałowe wyników pośrednich, sum CRC danych konfiguracyjnych i sum kontrolnych pamięci.
Autotesty: CPU, RAM, ROM, układy watchdog i monitorowanie zegara.
Testy sprawdzające (proof tests) w odstępie T1 – dla uszkodzeń, których diagnostyka bieżąca nie wykrywa.
Pokrycie diagnostyczne (DC) dzieli intensywność uszkodzeń niebezpiecznych każdego kanału na część wykrytą i niewykrytą, więc wpływa na każdy z dalszych wzorów:
λ_DD = DC · λ_Dλ_DU = (1 − DC) · λ_D
Wzór 4 – Intensywność wykrytych i niewykrytych uszkodzeń niebezpiecznych
2oo3 a 2oo2: porównanie, które ma znaczenie
Dwa znaczenia „2oo2”
To najczęstsze źródło nieporozumień na przeglądach i audytach.
Notacja przemysłu procesowego (IEC 61508 / IEC 61511): MooN określa, ile kanałów musi zażądać wyzwolenia (czyli działania bezpiecznego). Obowiązuje typowa konwencja wyzwolenia przez odwzbudzenie (de-energise-to-trip).
2oo2 – oba kanały muszą zagłosować za wyzwoleniem. Jedno niebezpieczne uszkodzenie kanału (kanał nie może wyzwolić) wystarcza, żeby funkcja zawiodła. Bezpieczeństwo jest niskie, a fałszywe zadziałania rzadkie.
1oo2 – każdy z kanałów może wyzwolić. Funkcja zawodzi dopiero wtedy, gdy oba kanały ulegną uszkodzeniu niebezpiecznemu. Bezpieczeństwo jest wysokie, a fałszywe zadziałania częstsze.
Notacja kolejowa, czyli komputerów fail-safe opartych na zasadzie bezpieczeństwa złożonego (composite fail-safety, kontekst EN 50126/50128/50129): „2oo2” określa, ile kanałów musi się zgodzić, zanim pojawi się jakiekolwiek wyjście.
Wyjście zezwalające – np. sygnał zezwalający na semaforze, zezwolenie na jazdę (MA) albo polecenie przestawienia zwrotnicy – pojawia się tylko wtedy, gdy oba kanały są zgodne. Każda niezgodność prowadzi do stanu bezpiecznego.
Z punktu widzenia zagrożenia oba kanały muszą ulec uszkodzeniu w ten sam błędny sposób, żeby pojawiło się niebezpieczne wyjście. Każdy kanał z osobna może wymusić stan bezpieczny.
W terminologii procesowej jest to bliższe 1oo2 pod względem bezpieczeństwa i 2oo2 pod względem dostępności (żeby system działał, oba kanały muszą być sprawne).
Kolejowe 2oo2 daje więc wysokie bezpieczeństwo i niską dostępność.
Te same symbole, odwrotne właściwości
Zanim zinterpretujesz wskaźnik niezawodności systemu „2oo2”, sprawdź, do jakiego działania odnosi się „2”: do wyzwolenia czy do wyjścia zezwalającego.
W dalszej części tej sekcji:
„2oo2 (procesowe)” oznacza 2oo2 w rozumieniu IEC 61508-6: oba kanały muszą zagłosować za wyzwoleniem.
„2oo2 (fail-safe)” oznacza znaczenie kolejowe, oparte na zasadzie bezpieczeństwa złożonego; pod względem bezpieczeństwa zachowuje się ono jak 1oo2.
1oo2D, 2oo2D i pokrewne warianty
1oo2D: architektura 1oo2 z diagnostyką. Wykryte uszkodzenie jednego kanału wyłącza go, a drugi pracuje dalej jako 1oo1, co poprawia dostępność w porównaniu ze zwykłym 1oo2. To jedna z architektur ujętych w tablicach IEC 61508-6.
2oo2D: architektura 2oo2 z diagnostyką, która potrafi wyłączyć kanał z wykrytym uszkodzeniem, tak że system pracuje dalej na sprawnym kanale. Nie należy do zestawu wzorów IEC 61508-6.
2×2oo2: dwie jednostki 2oo2 (fail-safe) w gorącej rezerwie – druga typowa w kolejnictwie odpowiedź na problem dostępności 2oo2 (fail-safe). Daje dostępność zbliżoną do TMR dzięki redundancji par fail-safe zamiast głosowania większościowego.
Architektura 2oo2D pojawia się w literaturze o niezawodności sterowników bezpieczeństwa (safety PLC) i w dokumentacji producentów, a jej definicje się różnią. Zanim porównasz liczby, sprawdź, jaką definicję przyjął dany autor.
Uproszczone wzory z IEC 61508-6
Załącznik B normy IEC 61508-6 podaje równania PFD i PFH dla architektur 1oo1, 1oo2, 2oo2, 1oo2D i 2oo3. Uwzględniają one pokrycie diagnostyczne, czasy naprawy i osobne współczynniki β dla uszkodzeń wykrytych i niewykrytych.
Poniższe uproszczone postaci wynikają z tych równań przy następujących założeniach.
Założenia uproszczonych wzorów
identyczne kanały o intensywności niebezpiecznych niewykrytych uszkodzeń λDU na kanał
brak diagnostyki bieżącej (λDD = 0), więc wszystkie uszkodzenia niebezpieczne wykrywa dopiero test sprawdzający
doskonały test sprawdzający w odstępie T1
czas naprawy MRT/MTTR ≪ T1
czynniki (1 − β) przy składnikach niezależnych przybliżono jedynką, co jest nieco konserwatywne
β to udział wspólnej przyczyny w niebezpiecznych uszkodzeniach niewykrytych
notacja procesowa (żądanie wyzwolenia) dla 1oo2 i 2oo2
Tryb małego zapotrzebowania (low demand), średnie prawdopodobieństwo niebezpiecznego uszkodzenia na żądanie (PFDavg). Tabela zestawia cztery architektury, a blok wzorów podaje te same równania w pełnej postaci:
Wzór 5 – Uproszczone PFDavg, bez diagnostyki (na podstawie IEC 61508-6, załącznik B)
Skąd te wzory? W IEC 61508-6, bez diagnostyki i przy MRT ≪ T1, równoważny średni czas niezdatności kanału wynosi tCE ≈ T1/2, a równoważny czas niezdatności systemu tGE ≈ T1/3. Po podstawieniu otrzymujemy składniki niezależne:
Wzór 6 – Składniki niezależne z równań IEC 61508-6
Współczynnik 6 dla 2oo3 (wobec 2 dla 1oo2) bierze się stąd, że trzy kanały tworzą trzy pary, a uszkodzenie dowolnej pary oznacza utratę funkcji. W 2oo2 (procesowym) każdy z dwóch kanałów sam może spowodować utratę funkcji, więc składnik jednokanałowy jest podwojony.
Tryb dużego zapotrzebowania lub ciągły (high demand / continuous), średnia częstość niebezpiecznych uszkodzeń (PFH):
Wzór 7 – Uproszczone PFH, bez diagnostyki (na podstawie IEC 61508-6, załącznik B)
Wzory te przyjmują tCE ≈ T1/2 i są przybliżeniem pierwszego rzędu.
Nie do weryfikacji SIL. Do rzeczywistej weryfikacji SIL potrzebne są pełne równania z IEC 61508-6 z faktycznymi wartościami λDD, pokrycia diagnostycznego, βD i MRT albo model Markowa lub drzewo niezdatności. Uproszczone postaci służą wyłącznie do zrozumienia zależności i szybkiego porównania.
Perspektywa kolejowa. W kolejowych dowodach bezpieczeństwa (safety case) według EN 50129 intensywność zagrożeń systemu fail-safe opartego na bezpieczeństwie złożonym uzasadnia się zwykle dwoma czasami:
czas wykrycia – jak szybko zostaje wykryta niezgodność albo uszkodzenie zgłoszone przez diagnostykę
czas negacji – jak szybko system osiąga stan bezpieczny
Idea matematyczna jest ta sama: niebezpieczny skutek wymaga drugiego, współwystępującego uszkodzenia w określonym oknie czasowym. Argumentacja jest po prostu ujęta inaczej niż w tablicach IEC 61508-6.
Niech λS oznacza intensywność uszkodzeń bezpiecznych na kanał, czyli takich, po których kanał żąda wyzwolenia. Załóżmy, że kanał, który fałszywie zadziałał, zostaje wykryty i naprawiony w czasie MTTR. W pierwszym przybliżeniu:
1oo2 wyzwala przy każdym pojedynczym uszkodzeniu bezpiecznym. 2oo2 (procesowe) i 2oo3 potrzebują dwóch współwystępujących uszkodzeń bezpiecznych albo jednego spowodowanego wspólną przyczyną.
W 2oo3 pierwsze uszkodzenie bezpieczne pojawia się z intensywnością 3 · λS, a potem jeden z dwóch pozostałych kanałów musi się uszkodzić w czasie MTTR (2 · λS · MTTR). Stąd współczynnik 6.
Dlatego 2oo2 (procesowe) ma najmniej fałszywych zadziałań i najgorsze bezpieczeństwo. Z tego samego powodu 2oo3 zbliża się do 2oo2 pod względem fałszywych zadziałań, a jednocześnie pozostaje blisko 1oo2 pod względem bezpieczeństwa.
Przykład obliczeniowy
Poniższe liczby są przykładowe – dobrałem je wyłącznie po to, żeby pokazać proporcje między składnikami. Nie pochodzą z żadnego rzeczywistego produktu. Dane wejściowe:
Parametr
Wartość
λDU na kanał
1 × 10⁻⁶ /h
Odstęp testów sprawdzających T1
1 rok = 8760 h
β
5% (0,05)
λS na kanał
5 × 10⁻⁶ /h
MTTR
8 h
Dwie wielkości, które występują w każdym składniku PFDavg:
PFDavg. Tabela rozbija każdy wynik na składnik niezależny i składnik CCF:
Architektura
Składnik niezależny
Składnik CCF
PFDavg
Przedział SIL, małe zapotrzebowanie (tylko PFD)
1oo1
4,38 × 10⁻³
—
4,4 × 10⁻³
SIL 2
2oo2 (procesowe)
8,76 × 10⁻³
—
8,8 × 10⁻³
SIL 2 (gorzej niż 1oo1)
1oo2
2,56 × 10⁻⁵
2,19 × 10⁻⁴
2,4 × 10⁻⁴
SIL 3
2oo3
7,67 × 10⁻⁵
2,19 × 10⁻⁴
3,0 × 10⁻⁴
SIL 3
W 1oo2 i 2oo3 składnik CCF jest mniej więcej 3–9 razy większy od składnika niezależnego. Jeśli powtórzyć obliczenia dla β = 1%, składnik CCF spada do 4,38 × 10⁻⁵:
Gdy redundancja już jest, najskuteczniejszą dźwignią jest zmniejszenie β. W tym przykładzie poprawia wynik 1oo2 mniej więcej 3,5-krotnie.
Trzeci kanał w ogóle nie poprawia PFDavg. 2oo3 wypada nawet nieco gorzej niż 1oo2, bo ma trzy pary kanałów, które mogą się uszkodzić, a nie jedną.
Trzeci kanał kupuje dostępność – co widać w liczbach dotyczących fałszywych zadziałań.
PFD to nie wszystko, co decyduje o SIL
Powyższe przedziały SIL dotyczą wyłącznie PFD. Osiągalny SIL ograniczają też wymagania architektoniczne (tolerancja uszkodzeń sprzętu i udział uszkodzeń bezpiecznych) oraz zdolność systematyczna.
Częstość fałszywych zadziałań. Dla λS = 5 × 10⁻⁶ /h i MTTR = 8 h:
Architektura
Częstość (/h)
Ok. na rok
Mniej więcej jedno zadziałanie co
1oo1
5 × 10⁻⁶
0,044
23 lata
1oo2
1 × 10⁻⁵
0,088
11 lat
2oo2 (procesowe)
4 × 10⁻¹⁰ + 2,5 × 10⁻⁷ ≈ 2,5 × 10⁻⁷
0,0022
460 lat
2oo3
1,2 × 10⁻⁹ + 2,5 × 10⁻⁷ ≈ 2,5 × 10⁻⁷
0,0022
460 lat
Znów dominuje wspólna przyczyna. Przy tych liczbach 2oo3 dorównuje 2oo2 (procesowemu) pod względem fałszywych zadziałań i pozostaje blisko 1oo2 pod względem bezpieczeństwa. Właśnie dla tego połączenia stosuje się TMR.
Tabela porównawcza
Tabela zestawia trzy zachowania obok siebie:
Kryterium
1oo2 (procesowe) / 2oo2 (fail-safe)
2oo2 (procesowe)
2oo3
Bezpieczeństwo (uszkodzenia niebezpieczne)
Wysokie: potrzeba dwóch uszkodzeń niebezpiecznych
Niskie: jedno uszkodzenie niebezpieczne wystarcza do utraty funkcji
Wysokie: potrzeba dwóch uszkodzeń niebezpiecznych
Dostępność / fałszywe zadziałania
Niska: każde pojedyncze uszkodzenie to wyzwolenie lub stan bezpieczny
Wysoka: potrzeba dwóch uszkodzeń bezpiecznych
Wysoka: potrzeba dwóch uszkodzeń bezpiecznych
Zachowanie po 1. uszkodzeniu
Stan bezpieczny (fail-safe) albo wyzwolenie (1oo2); 1oo2D może pracować dalej jako 1oo1
Po uszkodzeniu bezpiecznym pracuje dalej jako 1oo1; uszkodzenie niebezpieczne oznacza utratę funkcji
Przegłosowuje uszkodzony kanał, pracuje dalej jako 2oo2 / 1oo2 w trybie zdegradowanym
Sprzęt
2 kanały + komparator
2 kanały + logika AND/OR
3 kanały + układ głosowania większościowego + wymiana danych
Koszt i złożoność
Średnie
Średnie
Wysokie: układ głosujący, synchronizacja, uzgadnianie wejść
Wrażliwość na CCF
Składnik β często dominuje
Mało istotna (i tak wrażliwe na pojedyncze uszkodzenie)
Składnik β często dominuje
Tolerancja uszkodzeń sprzętu (niebezpiecznych)
1
0
1
Typowe zastosowanie
Kolejowe komputery fail-safe, wyłączenia awaryjne tam, gdzie wyzwolenia są akceptowalne
Gdy fałszywe zadziałania są bardzo kosztowne, a docelowy SIL umiarkowany
Funkcje, które muszą być jednocześnie bardzo bezpieczne i bardzo dostępne
Typowe obszary zastosowań
Sterowanie ruchem kolejowym
Komputerowe urządzenia zależnościowe i platformy RBC zwykle wymagają SIL 4 dla funkcji bezpieczeństwa. Muszą też mieć bardzo wysoką dostępność, bo bezpieczne wyłączenie zatrzymuje ruch na całym obszarze.
Platformy stosowane w praktyce opierają się na jednym z dwóch wzorców (opisuję je tu tylko ogólnie):
komputery fail-safe 2oo3 oparte na zasadzie bezpieczeństwa złożonego, które po pierwszym uszkodzeniu kanału degradują się do 2oo2
2×2oo2: zdublowana para fail-safe z przełączaniem
Oba wzorce mają ten sam cel: bezpieczeństwo na poziomie SIL 4 dzięki zgodności kanałów fail-safe i dostępność dzięki trzeciemu kanałowi albo parze rezerwowej.
Wybór jednego z nich to decyzja na poziomie systemu, zależna od koncepcji utrzymania, sposobu przełączania i kosztów cyklu życia. Przydział zagrożeń i poziomów SIL, na którym ta decyzja się opiera, wynika z procesu RAMS według EN 50126.
Przemysł procesowy (IEC 61508 / IEC 61511)
Sterowniki bezpieczeństwa TMR od dziesięcioleci pracują w przyrządowych systemach bezpieczeństwa (SIS), np. w systemach wyłączeń awaryjnych, zarządzania palnikami oraz detekcji pożaru i gazu.
Urządzenia obiektowe także często konfiguruje się w układzie 2oo3, np. trzy przetworniki ciśnienia z wyborem mediany. Fałszywe zadziałania w dużej instalacji są kosztowne i same mogą stwarzać zagrożenia podczas wyłączania i ponownego rozruchu.
Sterowanie lotem w awionice
Dobrze znanym przykładem potrójnej redundancji jest publicznie opisany główny system sterowania lotem Boeinga 777. Ma trzy główne komputery sterowania lotem, a każdy z nich zawiera trzy wewnętrzne tory (lanes) zbudowane na różnych procesorach.
Zarządzanie redundancją łączy porównywanie między torami i między komputerami z różnorodnością rozwiązań, żeby przeciwdziałać zarówno uszkodzeniom losowym, jak i spowodowanym wspólną przyczyną.
Inne rodziny samolotów opierają się raczej na parach command/monitor i różnorodnych komputerach zapasowych. To przypomnienie, że TMR jest jedną z kilku dróg do wysokiej nienaruszalności bezpieczeństwa, a nie jedyną.
Lista kontrolna projektu
Czy układ głosujący opracowano na docelowy SIL i czy przy uszkodzeniu przechodzi w stan bezpieczny?
Czy testy okresowe wykrywają uszkodzenia ukryte (kanał zablokowany w stanie bezpiecznym, kanał przegłosowywany po cichu)?
Czy uzgadnianie wejść jest zdefiniowane: okna tolerancji, liczniki czasu rozbieżności, przesunięcie próbkowania?
Czy wymiana danych jest zabezpieczona przed niespójnymi (bizantyjskimi) komunikatami?
Czy zachowanie w trybie zdegradowanym (2oo2, 1oo2 albo wyłączenie) jest określone i uzasadnione?
Czy maksymalny czas pracy w trybie zdegradowanym jest określony i egzekwowany?
Czy β wyznaczono systematycznie (np. metodą z załącznika D IEC 61508-6), a nie po prostu założono?
Czy przy każdym „2oo2” jest jasne, czy „2” dotyczy wyzwolenia, czy wyjścia zezwalającego?
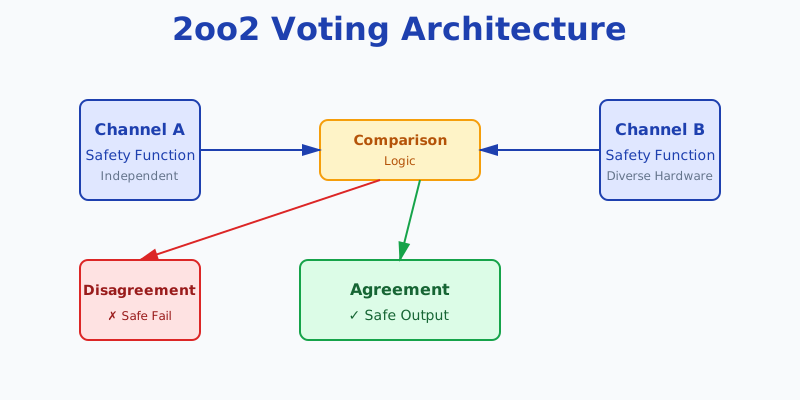
How 2oo2 composite fail-safe architectures work in railway signalling and safety computing: cross-checking, synchronisation, detection time, common-cause failures and the comparison with 2oo3.Jak działają architektury 2oo2 oparte na zasadzie bezpieczeństwa złożonego w urządzeniach srk: porównanie krzyżowe, synchronizacja, czas wykrycia, uszkodzenia spowodowane wspólną przyczyną i porównanie z 2oo3.
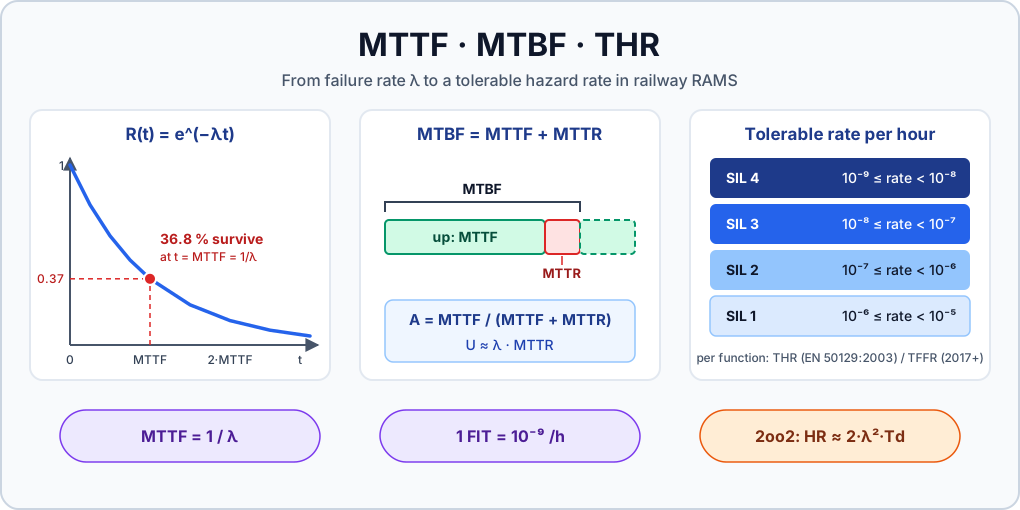
A practical guide to failure rate, FIT, MTTF, MTBF, MTTR, availability and Tolerable Hazard Rate (THR) in railway RAMS per EN 50126 and EN 50129, with step-by-step worked examples for series, redundant and 2oo2 fail-safe systemsPraktyczny przewodnik po intensywności uszkodzeń, FIT, MTTF, MTBF, MTTR, gotowości i dopuszczalnej intensywności zagrożeń (THR) w kolejowym RAMS wg EN 50126 i EN 50129, z przykładami obliczeń krok po kroku dla układów szeregowych, redundantnych i bezpiecznych układów 2oo2
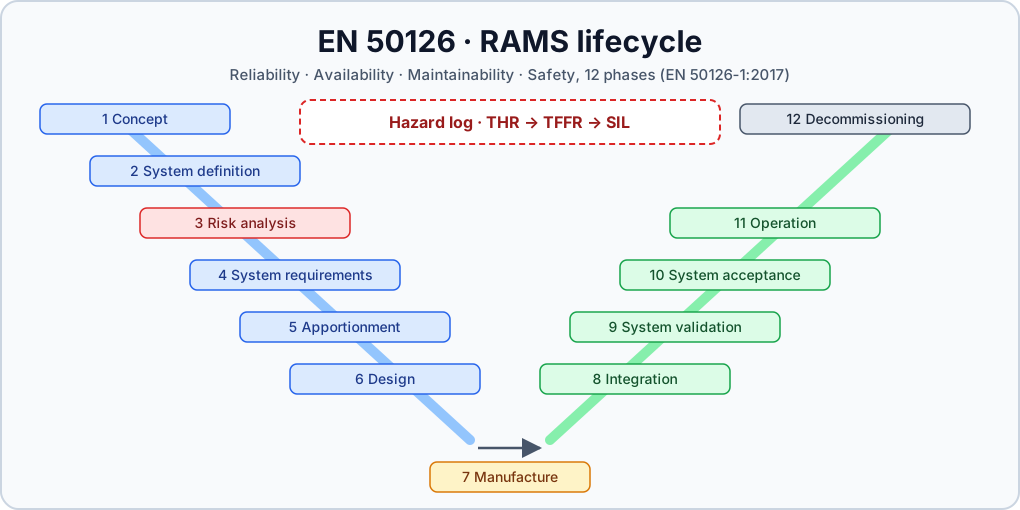
A practical guide to EN 50126-1/-2:2017: the 12-phase RAMS lifecycle, hazard log, CSM-RA-aligned risk acceptance, roles, independent safety assessment and THR/TFFR/SIL apportionment.Praktyczny przewodnik po EN 50126-1/-2:2017: 12-fazowy cykl życia systemu, rejestr zagrożeń, zasady akceptacji ryzyka zgodne z CSM-RA, role, niezależna ocena bezpieczeństwa oraz podział THR/TFFR/SIL.