2oo2 Architecture: Two-Channel Fail-Safe Design in Railway SystemsArchitektura 2oo2: dwukanałowe systemy fail-safe w kolejnictwie
How 2oo2 composite fail-safe architectures work in railway signalling and safety computing: cross-checking, synchronisation, detection time, common-cause failures and the comparison with 2oo3.Jak działają architektury 2oo2 oparte na zasadzie bezpieczeństwa złożonego w urządzeniach srk: porównanie krzyżowe, synchronizacja, czas wykrycia, uszkodzenia spowodowane wspólną przyczyną i porównanie z 2oo3.
Two-out-of-two (2oo2) is the workhorse architecture of railway safety computing. Electronic interlockings, ETCS on-board units, RBCs and axle-counter evaluators are frequently built on 2oo2, 2×2oo2 or 2oo3 platforms.
The idea is simple, but the details (what is compared, when, and how quickly a fault is caught) decide whether the architecture actually delivers the safety integrity claimed for it.
This article is for system, hardware and software engineers who design, assess or verify two-channel safety-related systems in an EN 50126/50128/50129 context.
If you need the three-channel case, see the companion article on 2oo3 architecture.
The 2oo2 Principle
A 2oo2 fail-safe system has four essential elements:
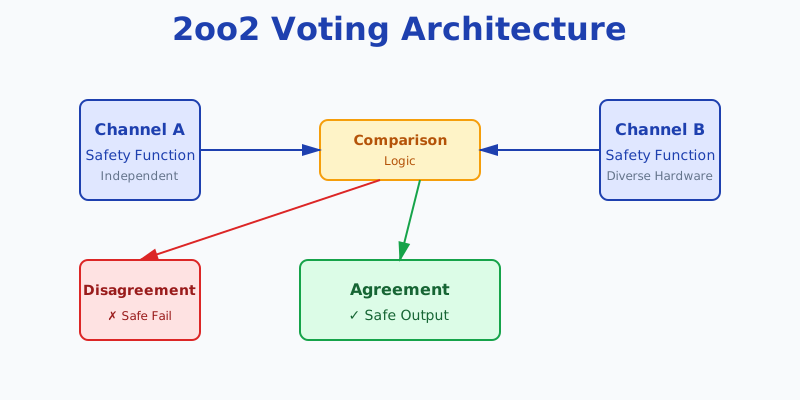
Two independent channels (A and B) execute the same safety function on the same inputs.
Cross-checking compares the channels’ results, and often their inputs and internal states too.
Agreement is required for any permissive output. A proceed aspect, a movement authority or a point command is issued only when both channels agree.
Disagreement or a diagnostic fault leads to the safe state, for example a restrictive aspect, brake application, or de-energised outputs.
              +-------------+
  inputs ---->|  Channel A  |----+
     |        +-------------+    |     +------------------+
     |              ^            +---->|  output stage    |
     |              | cross-check      |  (A AND B must   |---> output
     |              v            +---->|   permit)        |
     +------->+-------------+    |     +------------------+
              |  Channel B  |----+
              +-------------+
     either channel alone can force the safe state
The diagram shows two channels reading the same inputs and exchanging results over a cross-check link.
The output stage acts as an AND: the permissive output exists only while both channels actively permit it. Either channel, on its own, can withdraw permission and drive the output to the safe state.
The key insight
In railway 2oo2, agreement is the only path to a permissive output. Disagreement is not “unsafe”; it is the trigger for the safe state. The price is availability, not safety.
Composite fail-safety
EN 50129 describes several techniques for achieving fail-safety: composite, reactive and inherent fail-safety. A 2oo2 system is the classic example of composite fail-safety, which rests on four conditions:
Each safety-related function is performed by at least two items.
The items are independent of each other.
A non-restrictive (permissive) state requires agreement between them.
A fault in one item is detected and negated in time, so that the probability of a second fault occurring before negation is acceptably low.
That last condition is the heart of the safety argument, and it is what the rest of this article is about.
Two Meanings of “2oo2”
“2oo2” means opposite things in the process industry and in railway signalling. This is the most common source of confusion when you compare figures across standards and suppliers.
Aspect
2oo2 (process, IEC 61508/61511)
2oo2 (railway fail-safe)
What the “2” counts
Channels that must demand the trip
Channels that must agree before a permissive output
Effect of one dangerous channel fault
Function defeated (cannot trip)
Detected by cross-check, safe state
Safety
Lower than 1oo1
High; behaves like 1oo2 for safety
Spurious trips / availability
Few spurious trips
Any single fault stops the function
Typical use
Where spurious trips are very costly
Signalling and train-control safety computers
In this article, “2oo2” always means the railway fail-safe sense. The 2oo3 architecture article uses the labels “2oo2 (process)” and “2oo2 (fail-safe)” to keep the two apart, and gives the IEC 61508-6 formulas for the process variants.
Warning
Before you use a reliability figure quoted for a “2oo2” system, check which action the “2” refers to: the trip or the permissive output. The two give opposite safety and availability characteristics.
How a Single Fault Is Handled
Consider a random hardware fault in channel A. Three outcomes are possible:
Fault effect in channel A
What the cross-check sees
Result
A computes a different (wrong) result
Disagreement with B
Safe state, fault reported
A stops, crashes or misses its deadline
Missing or late result
Safe state by timeout
A fault is latent (not yet affecting outputs)
Nothing, yet
Undetected until exercised or tested
The first two cases are what 2oo2 is built for. The third case is the dangerous one: a latent fault sits in channel A while channel B continues to carry the function alone.
If B now develops a fault that produces the same wrong output, the comparison passes and a dangerous output appears.
This is why the common simplification “a single channel failure is undetectable” is wrong. A single active fault is detected by comparison.
What comparison cannot see is a fault that has not yet changed anything that is compared. Self-tests exist to close that gap.
Detection Time and Hazard Rate
A first-order model
Assume two channels with independent faults, and define:
λ_A, λ_B: the rates of channel faults that could lead to a wrong-side output.
T_A, T_B: the time from a fault in that channel until the system has detected it and reached the safe state (detection time plus negation time).
A dangerous output requires one channel to fail and the other to fail within that window, in a way that gives the same wrong result. Conservatively assuming the second fault always matches the first:
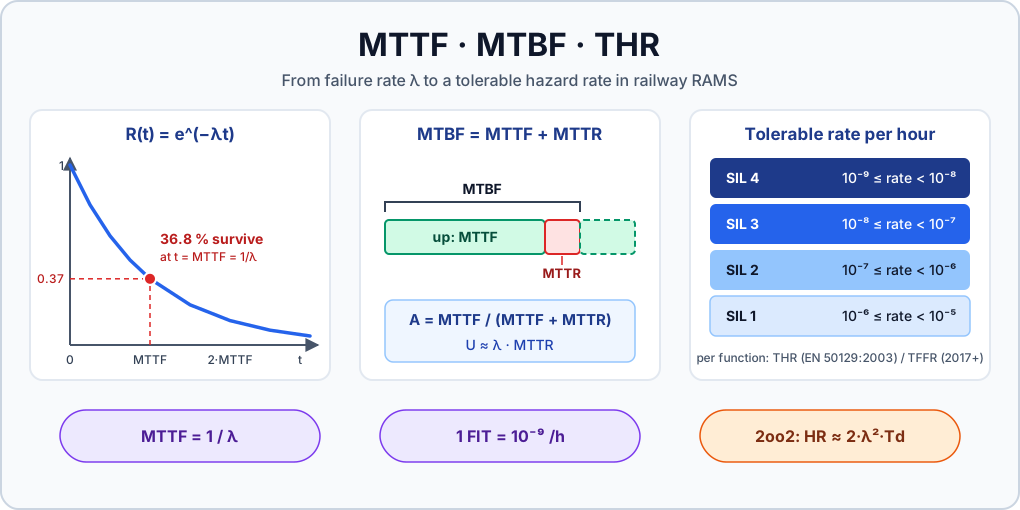
HR_ind ≈ λ_A · λ_B · (T_A + T_B)identical channels: HR_ind ≈ 2 · λ² · TT = detection time + negation time (h), λ in /h
Eq. 1 – Independent-fault hazard rate of a 2oo2 pair (first order, λ·T ≪ 1)
Common-cause failures add a term that does not depend on T at all, because both channels fail at the same moment and in the same way. With the simple beta-factor model:
HR ≈ 2 · λ² · T + β · λβ = fraction of channel faults that hit both channels identically
Eq. 2 – Hazard rate including common-cause failures
These equations are a model for intuition, not a substitute for the quantitative analysis in the safety case (fault trees, Markov models and FMEA as required by EN 50126-2 and EN 50129).
The numbers below are illustrative only, chosen to show how the terms compare. They are not data from any real product. Take λ = 1 × 10⁻⁵ /h per channel for faults that could produce a wrong-side output.
Detection + negation time T
T (h)
HR_ind = 2·λ²·T (/h)
1 s (cycle-level comparison)
2.8 × 10⁻⁴
5.6 × 10⁻¹⁴
1 h
1
2.0 × 10⁻¹⁰
24 h (daily self-test)
24
4.8 × 10⁻⁹
30 days (monthly test)
720
1.4 × 10⁻⁷
With the same λ, the CCF term is β · λ = 1 × 10⁻⁷ /h for β = 1 %, and 1 × 10⁻⁸ /h for β = 0.1 %.
For comparison, EN 50129 associates SIL 4 with a tolerable hazard rate of 10⁻⁹ /h ≤ THR < 10⁻⁸ /h per function (expressed as TFFR in EN 50129:2018). Two conclusions follow:
For faults caught by cycle-by-cycle comparison, the independent term is negligible.
The budget is consumed by latent faults with long test intervals and by common-cause failures. That is where the design effort must go.
Note
Only common-cause faults that make both channels produce the same wrong output are dangerous. A common-cause fault that crashes both channels, or makes them disagree, leads to the safe state. Good design pushes CCF effects towards detectable, disagreeing or fail-stop behaviour.
Cross-Checking: What to Compare
Comparing only the final outputs is the minimum. Stronger designs compare at several levels:
Level
What is compared
Faults it catches
Inputs
Raw or consolidated input values
Input circuit faults, sampling differences
Internal state
Key variables, state machines, CRCs of data
Memory and processing faults before they reach outputs
Outputs
Commanded output values
Any fault that changes the result
Output readback
Actual state of the output stage
Stuck output drivers, welded relay contacts
Where the comparator lives
The comparator must not become a single point of failure. Two common approaches:
Mutual cross-checking in software. Each channel receives the other’s results over a cross-channel link, compares them itself and can withdraw its own permission. There is no separate voter to fail.
Fail-safe hardware comparator or output stage. Both channels must actively drive a dynamic signal or energise series contacts, so a dead or stuck channel cannot hold the output in the permissive state.
In both cases, each channel needs an independent shutdown path: a way to force the safe state that does not depend on the other channel, the comparator logic or shared software.
Tip
Prefer a dynamic (pulsed or coded) “permit” signal over a static level. A static signal can be held by a stuck driver; a dynamic one disappears when the channel stops computing correctly.
Synchronisation
Two channels can only be compared if they compute “the same thing at the same time”.
Lockstep vs loosely synchronised channels
Lockstep. Both processors execute identical instructions on the same clock and are compared at bus or instruction level. Detection is extremely fast, but the near-identical channels limit diversity and make some common-cause faults harder to detect.
Loosely synchronised. Each channel runs its own cycle and synchronises with the other at defined points (for example, once per application cycle) to exchange and compare results. This allows hardware and software diversity, but the synchronisation protocol and tolerances need careful design.
Input agreement
If the channels sample a changing input at slightly different moments, they may legitimately see different values and disagree. That is a safe outcome, but it destroys availability. Typical mitigations:
Exchange raw input values and agree on a common consolidated value before the safety logic runs.
Use tolerance bands for analogue values and time windows for events.
Treat any persistent input disagreement as a fault and go to the safe state.
Timeouts
Every exchange needs a deadline. A result that does not arrive in time must be treated as a disagreement. Design the time budget so that detection plus negation stays within the value of T assumed in the safety analysis.
Caution
Do not “wait a bit longer” for a late channel without bounding it. An unbounded wait silently increases T in Eq. 1, and with it the hazard rate.
Diagnostics and Latent Faults
Comparison catches active faults. Diagnostics are needed for faults that comparison cannot see:
Periodic self-tests of memory, CPU, I/O and the comparison mechanism itself, so that latent faults are revealed within a known interval.
Output tests and readback to show that each channel can still force the safe state.
Watchdogs that are independent of the channel they supervise.
Start-up tests before the system offers any permissive output.
The test interval for each latent fault class becomes the T for that class in the hazard calculation. A comparison that runs every cycle does not help if a stuck output driver is only checked once a month.
Common-Cause Failures and Diversity
Common-cause failures (CCF) are the main limit of any redundant architecture. Typical sources:
shared power supply, clock or EMC exposure
identical hardware with the same design defect
identical software with the same specification or coding error
the same maintenance error applied to both channels
Defences
The table lists typical defences against CCF and their limits.
Defence
Examples
Limit
Physical separation
Separate boards, supplies, cabling routes
Shared enclosure and environment remain
Hardware diversity
Different processor families or suppliers
Cost, two toolchains, two qualification efforts
Software diversity
Diverse compilers, data representations, independent implementations
Does not cover errors in the shared specification
Coded or inverted data
One channel works on inverted or encoded data
Needs careful design of the encoding
Process measures
Independent verification, staggered maintenance
Depends on organisation and competence
Warning
Diversity is not free safety. Two diverse implementations of a wrong requirement give the same wrong answer, and the cross-check will pass. Specification errors are systematic faults: they are addressed by the processes of EN 50128 / EN 50716 and EN 50129, not by redundancy.
For software, diversity and redundancy are listed among the techniques in EN 50128 and its successor EN 50716. See CENELEC EN 50128 and EN 50128 vs EN 50716 for how these techniques fit into the software lifecycle.
2oo2 vs 2oo3 and 2×2oo2
The table below compares the common railway architectures qualitatively. All entries assume the railway fail-safe sense.
Architecture
Channels
Single fault
Availability after one fault
Complexity
1oo1 (reactive or inherent fail-safe)
1
Must be detected by the channel itself
Function lost
Low
2oo2
2
Detected by cross-check, safe state
Function lost
Medium
2×2oo2
4
Faulty pair goes safe, standby pair takes over
Function continues
High
2oo3
3
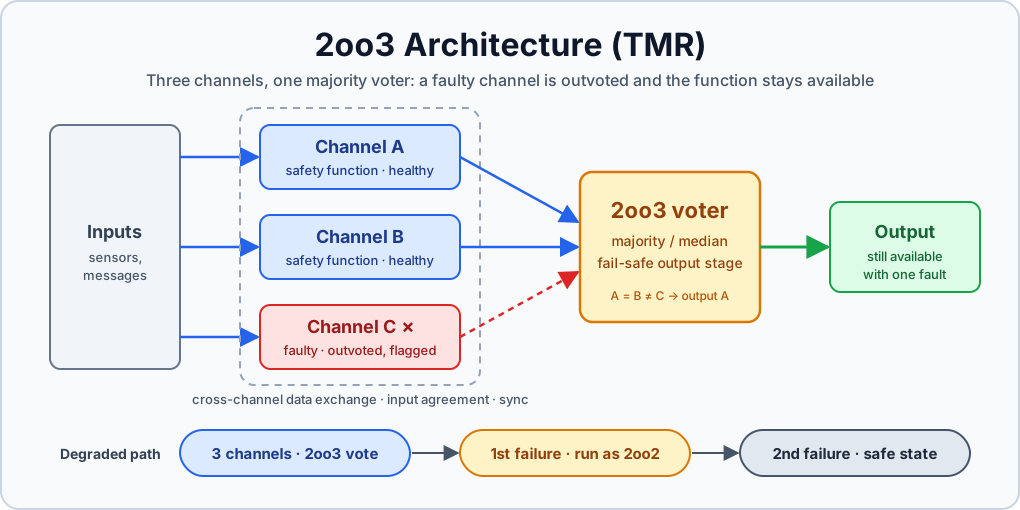
Faulty channel is outvoted and excluded
Continues as 2oo2
High
2oo2 is the simplest architecture that gives composite fail-safety. When the function must also be highly available, as in interlockings or RBCs, designers add redundancy at the next level:
a second 2oo2 pair in hot standby (2×2oo2), or
a third channel with majority voting (2oo3).
The 2oo3 architecture article covers the voter design, degraded modes and the IEC 61508-6 formulas in detail.
Common Mistakes
Confusing process and railway notation, and using a “2oo2” PFD figure from IEC 61508-6 for a railway fail-safe pair.
Comparing only outputs, so internal and latent faults are found too late.
Ignoring the test interval of latent faults when you calculate the hazard rate.
A single comparator or a shared shutdown path that turns the “two-channel” system into a single-channel one.
Assuming diversity removes CCF. It reduces some causes but not specification errors or shared environmental stress.
Unbounded waits for a late channel, which silently extend the detection time.
EN 50129: safety-related electronic systems for signalling
EN 50126-1 / EN 50126-2: RAMS process and systems approach to safety
IEC 61508-6, Annex B: PFD and PFH equations for MooN architectures
Architektura „dwa z dwóch” (2oo2) to koń pociągowy kolejowych komputerów bezpieczeństwa. Na platformach 2oo2, 2×2oo2 lub 2oo3 buduje się często elektroniczne urządzenia zależnościowe, urządzenia pokładowe ETCS, centra RBC i układy ewaluacji liczników osi.
Sama idea jest prosta, ale to szczegóły – co się porównuje, kiedy i jak szybko wykrywa się uszkodzenie – przesądzają o tym, czy architektura rzeczywiście osiąga deklarowany poziom nienaruszalności bezpieczeństwa (SIL).
Artykuł jest przeznaczony dla inżynierów systemowych, sprzętowych i oprogramowania, którzy projektują, oceniają lub weryfikują dwukanałowe systemy związane z bezpieczeństwem zgodnie z EN 50126/50128/50129.
System fail-safe 2oo2 opiera się na czterech elementach:
Dwa niezależne kanały (A i B) realizują tę samą funkcję bezpieczeństwa na tych samych danych wejściowych.
Porównanie krzyżowe zestawia wyniki obu kanałów, a często także ich wejścia i stany wewnętrzne.
Każde wyjście zezwalające wymaga zgodności. Sygnał zezwalający, zezwolenie na jazdę (MA) czy polecenie przestawienia zwrotnicy wydaje się tylko wtedy, gdy oba kanały się zgadzają.
Niezgodność lub uszkodzenie wykryte przez diagnostykę prowadzi do stanu bezpiecznego, np. sygnału zabraniającego, hamowania lub odwzbudzenia wyjść.
              +-------------+
  wejścia --->|   Kanał A   |----+
     |        +-------------+    |     +------------------+
     |              ^            +---->| stopień wyjściowy|
     |              | porównanie       |  (A I B muszą    |--> wyjście
     |              v            +---->|   zezwolić)      |
     +------->+-------------+    |     +------------------+
              |   Kanał B   |----+
              +-------------+
     każdy kanał sam może wymusić stan bezpieczny
Na diagramie dwa kanały odczytują te same wejścia i wymieniają wyniki przez łącze porównania krzyżowego.
Stopień wyjściowy działa jak bramka AND: wyjście zezwalające istnieje tylko tak długo, jak oba kanały aktywnie na nie zezwalają. Każdy kanał może samodzielnie cofnąć zezwolenie i sprowadzić wyjście do stanu bezpiecznego.
Najważniejsze
W kolejowym 2oo2 zgodność jest jedyną drogą do wyjścia zezwalającego. Niezgodność nie jest stanem niebezpiecznym – to sygnał do przejścia w stan bezpieczny. Płaci się za to dostępnością, a nie bezpieczeństwem.
Zasada bezpieczeństwa złożonego
EN 50129 opisuje kilka sposobów zapewnienia bezpieczeństwa przy uszkodzeniach (fail-safety): zasadę bezpieczeństwa złożonego, reaktywnego i wewnętrznego. System 2oo2 to klasyczny przykład zasady bezpieczeństwa złożonego (composite fail-safety), która opiera się na czterech warunkach:
Każdą funkcję związaną z bezpieczeństwem realizują co najmniej dwa elementy.
Elementy te są od siebie niezależne.
Stan niezabraniający (zezwalający) wymaga ich zgodności.
Uszkodzenie jednego elementu zostaje na czas wykryte i zneutralizowane, tak aby prawdopodobieństwo wystąpienia drugiego uszkodzenia przed neutralizacją było akceptowalnie małe.
Ostatni warunek jest sednem argumentacji bezpieczeństwa i jemu poświęcam resztę artykułu.
Dwa znaczenia „2oo2”
W przemyśle procesowym i w sterowaniu ruchem kolejowym „2oo2” znaczy coś odwrotnego. To najczęstsze źródło nieporozumień przy porównywaniu danych z różnych norm i od różnych dostawców.
Aspekt
2oo2 (procesowe, IEC 61508/61511)
2oo2 (kolejowe fail-safe)
Co liczy „2”
Kanały, które muszą zażądać wyłączenia
Kanały, które muszą się zgodzić przed wyjściem zezwalającym
Skutek jednego niebezpiecznego uszkodzenia kanału
Funkcja nie zadziała (brak wyłączenia)
Wykryte przez porównanie, stan bezpieczny
Bezpieczeństwo
Niższe niż 1oo1
Wysokie; pod względem bezpieczeństwa jak 1oo2
Fałszywe wyłączenia / dostępność
Mało fałszywych wyłączeń
Każde pojedyncze uszkodzenie zatrzymuje funkcję
Typowe zastosowanie
Gdy fałszywe wyłączenie jest bardzo kosztowne
Komputery bezpieczeństwa srk i systemów sterowania pociągiem
W tym artykule „2oo2” zawsze oznacza kolejowe znaczenie fail-safe. Artykuł o architekturze 2oo3 rozróżnia oba przypadki etykietami „2oo2 (process)” i „2oo2 (fail-safe)” i podaje wzory z IEC 61508-6 dla wariantów procesowych.
Warning
Zanim użyjesz wskaźnika niezawodności podanego dla systemu „2oo2”, sprawdź, do czego odnosi się „2”: do wyłączenia czy do wyjścia zezwalającego. Oba znaczenia dają przeciwne charakterystyki bezpieczeństwa i dostępności.
Obsługa pojedynczego uszkodzenia
Weźmy losowe uszkodzenie sprzętu w kanale A. Możliwe są trzy skutki:
Skutek uszkodzenia w kanale A
Co widzi porównanie krzyżowe
Wynik
A oblicza inny (błędny) wynik
Niezgodność z B
Stan bezpieczny, zgłoszenie uszkodzenia
A zatrzymuje się, zawiesza lub nie mieści się w terminie
Brak wyniku lub wynik spóźniony
Stan bezpieczny po przekroczeniu czasu
Uszkodzenie jest ukryte (jeszcze nie wpływa na wyjścia)
Na razie nic
Niewykryte, dopóki nie zostanie pobudzone lub przetestowane
Do obsługi dwóch pierwszych przypadków zbudowano 2oo2. Groźny jest trzeci: ukryte uszkodzenie tkwi w kanale A, a funkcję w praktyce niesie sam kanał B.
Jeśli teraz w B pojawi się uszkodzenie dające ten sam błędny wynik, porównanie przejdzie i powstanie niebezpieczne wyjście.
Dlatego popularne uproszczenie „pojedyncze uszkodzenie kanału jest niewykrywalne” jest błędne. Pojedyncze aktywne uszkodzenie zostaje wykryte przez porównanie.
Porównanie nie widzi natomiast uszkodzenia, które nie zmieniło jeszcze niczego, co podlega porównaniu. Tę lukę zamykają autotesty.
Czas wykrycia a intensywność zagrożeń
Model pierwszego rzędu
Załóżmy dwa kanały z niezależnymi uszkodzeniami i przyjmijmy oznaczenia:
λ_A, λ_B – intensywności tych uszkodzeń kanału, które mogą doprowadzić do niebezpiecznego (wrong-side) błędnego wyjścia.
T_A, T_B – czas od uszkodzenia w danym kanale do jego wykrycia i osiągnięcia stanu bezpiecznego (czas wykrycia plus czas neutralizacji).
Niebezpieczne wyjście wymaga, żeby jeden kanał uległ uszkodzeniu, a drugi – w tym oknie czasowym i w taki sposób, by dać ten sam błędny wynik. Przy zachowawczym założeniu, że drugie uszkodzenie zawsze „pasuje” do pierwszego:
HR_ind ≈ λ_A · λ_B · (T_A + T_B)kanały identyczne: HR_ind ≈ 2 · λ² · TT = czas wykrycia + czas neutralizacji (h), λ w /h
Wzór 1 – Intensywność zagrożeń od uszkodzeń niezależnych w parze 2oo2 (pierwszy rząd, λ·T ≪ 1)
Uszkodzenia spowodowane wspólną przyczyną dokładają składnik, który w ogóle nie zależy od T, bo oba kanały ulegają uszkodzeniu w tej samej chwili i w ten sam sposób. W prostym modelu współczynnika beta:
HR ≈ 2 · λ² · T + β · λβ = udział uszkodzeń kanału, które identycznie dotykają obu kanałów
Wzór 2 – Intensywność zagrożeń z uwzględnieniem uszkodzeń spowodowanych wspólną przyczyną
Te równania pomagają zbudować intuicję, ale nie zastępują analizy ilościowej w dowodzie bezpieczeństwa (drzew niezdatności, modeli Markowa i FMEA wymaganych przez EN 50126-2 i EN 50129).
Poniższe liczby są wyłącznie poglądowe – dobrałem je tylko po to, by pokazać proporcje między składnikami. Nie pochodzą z żadnego rzeczywistego produktu. Przyjmijmy λ = 1 × 10⁻⁵ /h na kanał dla uszkodzeń, które mogą dać niebezpieczne błędne wyjście.
Czas wykrycia + neutralizacji T
T (h)
HR_ind = 2·λ²·T (/h)
1 s (porównanie w każdym cyklu)
2,8 × 10⁻⁴
5,6 × 10⁻¹⁴
1 h
1
2,0 × 10⁻¹⁰
24 h (autotest raz na dobę)
24
4,8 × 10⁻⁹
30 dni (test raz w miesiącu)
720
1,4 × 10⁻⁷
Przy tym samym λ składnik CCF wynosi β · λ = 1 × 10⁻⁷ /h dla β = 1% oraz 1 × 10⁻⁸ /h dla β = 0,1%.
Dla porównania: EN 50129 przypisuje do SIL 4 dopuszczalną intensywność zagrożeń 10⁻⁹ /h ≤ THR < 10⁻⁸ /h na funkcję (w EN 50129:2018 wyrażaną jako TFFR). Wynikają z tego dwa wnioski:
Dla uszkodzeń wychwytywanych przez porównanie w każdym cyklu składnik niezależny jest pomijalny.
Budżet zjadają uszkodzenia ukryte o długich odstępach między testami oraz uszkodzenia spowodowane wspólną przyczyną. To na nich trzeba skupić wysiłek projektowy.
Note
Groźne są tylko te uszkodzenia spowodowane wspólną przyczyną, przy których oba kanały dają ten sam błędny wynik. CCF, który zawiesza oba kanały albo wywołuje między nimi niezgodność, kończy się stanem bezpiecznym. Dobry projekt przesuwa skutki CCF w stronę zachowań wykrywalnych, niezgodnych lub typu fail-stop.
Porównanie krzyżowe: co porównywać
Porównywanie samych wyjść końcowych to minimum. Mocniejsze rozwiązania porównują dane na kilku poziomach:
Poziom
Co jest porównywane
Jakie uszkodzenia wykrywa
Wejścia
Surowe lub uzgodnione wartości wejściowe
Uszkodzenia obwodów wejściowych, różnice w próbkowaniu
Stan wewnętrzny
Kluczowe zmienne, automaty stanów, sumy CRC danych
Uszkodzenia pamięci i przetwarzania, zanim dotrą do wyjść
Komparator nie może stać się pojedynczym punktem uszkodzenia. Stosuje się dwa typowe podejścia:
Wzajemne porównanie krzyżowe w oprogramowaniu. Każdy kanał dostaje wyniki drugiego przez łącze międzykanałowe, sam je porównuje i może cofnąć własne zezwolenie. Nie ma osobnego układu głosującego, który mógłby się uszkodzić.
Sprzętowy komparator fail-safe lub stopień wyjściowy. Oba kanały muszą aktywnie generować sygnał dynamiczny albo zasilać połączone szeregowo styki, więc martwy lub zablokowany kanał nie utrzyma wyjścia w stanie zezwalającym.
W obu przypadkach każdy kanał potrzebuje niezależnej ścieżki wyłączenia: sposobu na wymuszenie stanu bezpiecznego, który nie zależy od drugiego kanału, logiki komparatora ani wspólnego oprogramowania.
Tip
Zamiast statycznego poziomu stosuj dynamiczny (impulsowy lub kodowany) sygnał „zezwolenia”. Sygnał statyczny może podtrzymać zablokowany sterownik; dynamiczny znika, gdy kanał przestaje poprawnie liczyć.
Synchronizacja
Dwa kanały można porównać tylko wtedy, gdy liczą „to samo w tym samym czasie”.
Lockstep a luźna synchronizacja
Lockstep. Oba procesory wykonują identyczne instrukcje w takt tego samego zegara i są porównywane na poziomie magistrali lub instrukcji. Wykrycie jest bardzo szybkie, ale niemal identyczne kanały ograniczają różnorodność i utrudniają wykrycie części uszkodzeń spowodowanych wspólną przyczyną.
Luźna synchronizacja. Każdy kanał wykonuje własny cykl i synchronizuje się z drugim w ustalonych punktach (np. raz na cykl aplikacji), żeby wymienić i porównać wyniki. Pozwala to na różnorodność sprzętu i oprogramowania, ale protokół synchronizacji i tolerancje wymagają starannego projektu.
Uzgadnianie wejść
Jeśli kanały próbkują zmieniające się wejście w nieco innych chwilach, mogą całkiem poprawnie zobaczyć różne wartości i się nie zgodzić. Taki wynik jest bezpieczny, ale rujnuje dostępność. Typowe środki zaradcze:
Wymiana surowych wartości wejściowych i uzgodnienie wspólnej wartości, zanim ruszy logika bezpieczeństwa.
Pasma tolerancji dla wartości analogowych i okna czasowe dla zdarzeń.
Traktowanie każdej utrzymującej się niezgodności wejść jako uszkodzenia i przejście do stanu bezpiecznego.
Limity czasu
Każda wymiana danych musi mieć termin. Wynik, który nie dotarł na czas, należy traktować jak niezgodność. Budżet czasowy trzeba tak zaprojektować, żeby wykrycie razem z neutralizacją zmieściło się w wartości T przyjętej w analizie bezpieczeństwa.
Caution
Nie „czekaj jeszcze chwilę” na spóźniony kanał, jeśli ten czas nie jest ograniczony. Nieograniczone oczekiwanie po cichu zwiększa T we wzorze 1, a razem z nim intensywność zagrożeń.
Diagnostyka i uszkodzenia ukryte
Porównanie wychwytuje uszkodzenia aktywne. Na uszkodzenia, których porównanie nie widzi, potrzebna jest diagnostyka:
Okresowe autotesty pamięci, procesora, wejść/wyjść i samego mechanizmu porównania, tak aby uszkodzenia ukryte ujawniały się w znanym przedziale czasu.
Testy wyjść i odczyt zwrotny, które wykazują, że każdy kanał wciąż potrafi wymusić stan bezpieczny.
Watchdogi niezależne od nadzorowanego kanału.
Testy rozruchowe, zanim system wystawi jakiekolwiek wyjście zezwalające.
Odstęp między testami dla danej klasy uszkodzeń ukrytych staje się wartością T tej klasy w obliczeniach intensywności zagrożeń. Porównanie w każdym cyklu nic nie da, jeśli zablokowany sterownik wyjścia sprawdza się raz w miesiącu.
Uszkodzenia spowodowane wspólną przyczyną i różnorodność
Uszkodzenia spowodowane wspólną przyczyną (CCF) to główne ograniczenie każdej architektury redundantnej. Typowe źródła:
wspólne zasilanie, zegar lub narażenie na zaburzenia elektromagnetyczne (EMC),
identyczny sprzęt z tą samą wadą projektową,
identyczne oprogramowanie z tym samym błędem specyfikacji lub kodu,
ten sam błąd utrzymaniowy popełniony w obu kanałach.
Środki obrony
Tabela zestawia typowe środki obrony przed CCF i ich ograniczenia.
Środek
Przykłady
Ograniczenie
Separacja fizyczna
Osobne płyty, zasilacze, trasy kablowe
Pozostaje wspólna obudowa i środowisko
Różnorodność sprzętu
Różne rodziny procesorów lub dostawcy
Koszt, dwa łańcuchy narzędzi, dwie kwalifikacje
Różnorodność oprogramowania
Różne kompilatory, reprezentacje danych, niezależne implementacje
Nie obejmuje błędów we wspólnej specyfikacji
Dane kodowane lub zanegowane
Jeden kanał pracuje na danych zanegowanych lub zakodowanych
Wymaga starannego zaprojektowania kodowania
Środki procesowe
Niezależna weryfikacja, rozłożone w czasie prace utrzymaniowe
Zależy od organizacji i kompetencji
Warning
Różnorodność nie daje bezpieczeństwa za darmo. Dwie różne implementacje błędnego wymagania dadzą ten sam błędny wynik, a porównanie krzyżowe go przepuści. Błędy specyfikacji to uszkodzenia systematyczne: chronią przed nimi procesy z EN 50128 / EN 50716 i EN 50129, a nie redundancja.
W oprogramowaniu różnorodność i redundancja należą do technik wymienionych w EN 50128 i zastępującej ją EN 50716. Jak te techniki wpisują się w cykl życia oprogramowania, opisuję w artykułach CENELEC EN 50128 oraz EN 50128 a EN 50716.
2oo2 a 2oo3 i 2×2oo2
Poniższa tabela porównuje jakościowo typowe architektury kolejowe. Wszystkie wiersze dotyczą kolejowego znaczenia fail-safe.
Architektura
Kanały
Pojedyncze uszkodzenie
Dostępność po jednym uszkodzeniu
Złożoność
1oo1 (bezpieczeństwo reaktywne lub wewnętrzne)
1
Musi zostać wykryte przez sam kanał
Funkcja utracona
Niska
2oo2
2
Wykryte przez porównanie, stan bezpieczny
Funkcja utracona
Średnia
2×2oo2
4
Uszkodzona para przechodzi w stan bezpieczny, pracę przejmuje para rezerwowa
Funkcja działa dalej
Wysoka
2oo3
3
Uszkodzony kanał zostaje przegłosowany i odłączony
Dalsza praca jako 2oo2
Wysoka
2oo2 to najprostsza architektura realizująca zasadę bezpieczeństwa złożonego. Gdy funkcja musi być także wysoko dostępna, jak w urządzeniach zależnościowych czy RBC, projektanci dodają redundancję o poziom wyżej:
drugą parę 2oo2 w gorącej rezerwie (2×2oo2) albo
trzeci kanał z głosowaniem większościowym (2oo3).
Projekt układu głosującego, tryby zdegradowane i wzory z IEC 61508-6 omawiam szczegółowo w artykule o architekturze 2oo3.
Typowe błędy
Mylenie notacji procesowej i kolejowej, np. użycie wartości PFD dla „2oo2” z IEC 61508-6 do kolejowej pary fail-safe.
Porównywanie wyłącznie wyjść, przez co uszkodzenia wewnętrzne i ukryte wychodzą na jaw za późno.
Pomijanie odstępu między testami uszkodzeń ukrytych przy obliczaniu intensywności zagrożeń.
Pojedynczy komparator lub wspólna ścieżka wyłączenia, które robią z systemu „dwukanałowego” system jednokanałowy.
Założenie, że różnorodność eliminuje CCF. Ogranicza część przyczyn, ale nie błędy specyfikacji ani wspólne narażenia środowiskowe.
Nieograniczone oczekiwanie na spóźniony kanał, które po cichu wydłuża czas wykrycia.
How 2oo3 (TMR) voting works, how to design the voter, what happens after the first channel failure, and how 2oo3 compares with 2oo2 and 1oo2 using IEC 61508-6 PFD/PFH formulas.Jak działa głosowanie 2oo3 (TMR), jak zaprojektować układ głosujący, co się dzieje po pierwszym uszkodzeniu kanału i jak 2oo3 wypada na tle 2oo2 i 1oo2 według wzorów PFD/PFH z IEC 61508-6.
A practical guide to failure rate, FIT, MTTF, MTBF, MTTR, availability and Tolerable Hazard Rate (THR) in railway RAMS per EN 50126 and EN 50129, with step-by-step worked examples for series, redundant and 2oo2 fail-safe systemsPraktyczny przewodnik po intensywności uszkodzeń, FIT, MTTF, MTBF, MTTR, gotowości i dopuszczalnej intensywności zagrożeń (THR) w kolejowym RAMS wg EN 50126 i EN 50129, z przykładami obliczeń krok po kroku dla układów szeregowych, redundantnych i bezpiecznych układów 2oo2
A practical guide to EN 50126-1/-2:2017: the 12-phase RAMS lifecycle, hazard log, CSM-RA-aligned risk acceptance, roles, independent safety assessment and THR/TFFR/SIL apportionment.Praktyczny przewodnik po EN 50126-1/-2:2017: 12-fazowy cykl życia systemu, rejestr zagrożeń, zasady akceptacji ryzyka zgodne z CSM-RA, role, niezależna ocena bezpieczeństwa oraz podział THR/TFFR/SIL.