Safety in System Design: Designing for Failure, Not Against ItBezpieczeństwo w projektowaniu systemów: projektuj z myślą o awariach
Core principles for designing safety-related systems: safe states, defence in depth, fault detection and reaction, containment, and how familiar resilience patterns map to functional safety.Podstawowe zasady projektowania systemów związanych z bezpieczeństwem: stan bezpieczny, obrona w głąb, wykrywanie uszkodzeń i reakcja na nie, izolowanie uszkodzeń oraz miejsce znanych wzorców odporności w bezpieczeństwie funkcjonalnym.
Safety is not something you add at the end of a project. It is a property of the whole design: of the architecture, the requirements, the code and the way the system behaves when parts of it break.
In railway signalling, in vehicle electronics and in many other domains, the question is not “will it fail?” but “what happens when it fails?”.
This article is for engineers who design or review systems where a failure can hurt people or damage equipment. It is also for software engineers who know resilience patterns from distributed systems and want to see how they relate to functional safety.
I refer to the railway standards (EN 50126, EN 50128, EN 50129) and to IEC 61508 and ISO 26262, which I have worked with in railway signalling and automotive projects.
Safety is not reliability
Reliability is the ability of an item to perform its function for a given time under given conditions. Safety is freedom from unacceptable risk of harm. The two are related, but they can pull in opposite directions.
The table below compares the two views.
Aspect
Reliability view
Safety view
Main question
How often does it fail?
What harm can a failure cause?
Good outcome
The function keeps working
The system reaches or stays in a safe state
Typical measure
Failure rate λ, MTTF, MTBF
Hazard rate, THR, SIL
Typical response to a fault
Retry, fail over, keep going
Detect, react, go to the safe state
Example conflict
Keep the train moving
Apply the brakes when in doubt
A train that brakes every time a sensor is in doubt is safe, but unreliable and unpopular. A train that ignores doubtful sensor data to stay on time is reliable until the day it is not safe.
Good design keeps both targets in view. EN 50126 treats them together as RAMS (reliability, availability, maintainability and safety) for exactly this reason. For the quantitative side, see MTTF, MTBF and THR.
From hazards to design
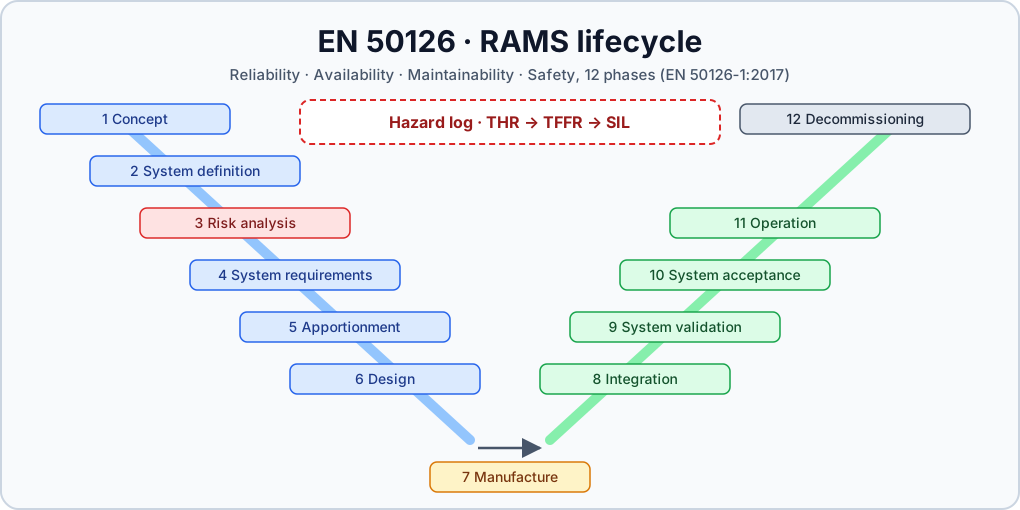
Safety-related design does not start with patterns. It starts with hazards. The EN 50126 lifecycle, simplified, looks like this:
The diagram reads left to right on the top row and right to left on the bottom row. Hazards are identified and their risk is evaluated.
The result is a set of safety requirements, including a tolerable hazard rate (THR) and a safety integrity level (SIL) for each safety function. The architecture is then designed to meet them, verified and validated, and the evidence is collected in the safety case.
Important
Every design decision in the rest of this article should trace back to a hazard and a safety requirement. A protection that does not address an identified hazard is cost and complexity, not safety.
In my work as a requirements engineer, keeping this chain traceable (hazard → safety requirement → design element → test) in a tool such as IBM DOORS has been at least as important as any single design pattern. A gap in that chain is a gap in the safety argument.
Core principles
Assume failure
Every component will fail eventually. Safety standards distinguish two kinds of failure:
Random hardware failures happen at an unpredictable time because of physical degradation. They are handled with probabilistic targets, redundancy and diagnostics.
Systematic failures are built in: a wrong requirement, a design error, a software bug. They occur every time the triggering conditions occur and are handled with process rigour (lifecycle, reviews, testing, tool qualification) according to the SIL.
Redundancy helps against random failures. Two identical copies of the same software bug do not help at all.
That is why higher integrity levels call for measures such as diversity, independent verification and stricter development techniques (EN 50128, IEC 61508-3).
Define the safe state
Before you can fail safe, you need to know what “safe” means for your system. A safe state is a state in which the hazard cannot occur, or its risk is acceptable. The table shows typical examples.
System
Typical safe state
Comment
Railway signal
Most restrictive aspect (stop)
Fail-safe: losing power must not show a proceed aspect
ETCS on-board unit
Brake application
The train is stopped and supervision is restored later
Industrial press
Motion stopped, guard locked
Achieved by de-energising
Electric power steering
Depends on the situation
Simply switching off may itself be a hazard
Aircraft flight controls
No passive safe state in flight
Requires fail-operational design
The last two rows matter. Not every system has a passive safe state.
If switching off is itself dangerous, the design must be fail-operational: it keeps a minimum safe function working after a fault, usually through redundancy such as 2oo3 voting.
Fail safe
Fail-safe design means that the credible failures of a component drive the system towards its safe state. EN 50129 describes three ways of achieving fail-safety for safety-related electronic systems, and all of them have classic examples in railway signalling:
Inherent fail-safety. The credible failure modes of the component itself are safe. The closed-circuit (de-energise to trip) principle is the typical case: a broken wire, a lost supply or a failed relay coil removes the energy, and the system falls back to the restrictive state.
Composite fail-safety. Two channels must agree before a permissive output is given. This is the idea behind the 2oo2 architecture: any disagreement leads to the safe state.
Reactive fail-safety. A single channel is used, but diagnostics detect faults quickly enough, and the reaction brings the system to the safe state in time.
The same idea applies outside safety-related systems. A payment service should not charge a customer twice because a retry happened after a timeout. The “safe” outcome is defined by the domain, and the design (here, idempotent requests) enforces it.
Fail-safe is not the same as “fails silently”
A component that stops sending messages is only fail-safe if the receiver detects the silence and reacts. Loss of communication must itself be a detected fault with a defined reaction.
Detect and react in time
Detection without a timely reaction is not enough. The time from the fault to the safe state must be shorter than the time in which the fault can turn into a hazard.
ISO 26262 calls that time the fault tolerant time interval (FTTI). IEC 61508 uses the term process safety time for a similar idea.
FDTI + FRTI ≤ FTTIFDTI = fault detection time interval (h, s or ms)FRTI = fault reaction time intervalFTTI = fault tolerant time interval
Eq. 1 – Timing condition for a safety mechanism (ISO 26262 terms)
Typical detection mechanisms are:
Watchdogs that detect a stuck or crashed program.
Plausibility and range checks on inputs, for example comparing two independent speed sensors.
Cross-comparison between redundant channels.
Periodic self-tests of memory, CPU and I/O.
Message freshness and integrity checks on communication.
The share of dangerous failures that diagnostics detect is called diagnostic coverage. In IEC 61508 it feeds directly into the hardware metrics for a SIL, and in an EN 50129 safety case it determines how quickly faults are found. It is a quantitative design parameter, not a vague quality goal.
Defence in depth
No single protection is perfect, so use several independent layers. Each layer should catch what the previous one missed, and the layers should not share a common cause of failure.
  hazard cause
       |
       v
  +---------------------------------------------------+
  | 1. Prevention: correct requirements, rigorous     |
  |    process, simple design                         |
  +---------------------------------------------------+
       |  residual faults
       v
  +---------------------------------------------------+
  | 2. Detection: diagnostics, plausibility checks,   |
  |    watchdogs, cross-comparison                    |
  +---------------------------------------------------+
       |  detected faults
       v
  +---------------------------------------------------+
  | 3. Reaction: transition to the safe state         |
  +---------------------------------------------------+
       |  reaction fails or is too late
       v
  +---------------------------------------------------+
  | 4. Mitigation: independent protection, operating  |
  |    rules, limiting consequences                   |
  +---------------------------------------------------+
The diagram shows four layers. A fault that passes the prevention layer should be detected, and a detected fault should lead to the safe state. If that reaction fails, an independent layer limits the consequences.
The key word is independent. Two layers that run on the same processor, use the same sensor or were written from the same flawed requirement may fail together. Common cause failure analysis is how you check this.
Contain faults
A fault in one part of the system should not propagate into another. In safety-related systems this is often called freedom from interference (ISO 26262) or separation between functions of different integrity levels.
Practical techniques include:
Partitioning in time and memory, for example with a separation kernel or a partitioned RTOS.
Separating safety-related functions from non-safety functions, so that a bug in diagnostics display code cannot corrupt the braking logic.
Defined interfaces with input validation at every boundary that crosses an integrity level.
Containment also keeps the safety case manageable. If non-safety software cannot interfere with the safety function, you do not need to develop it to the same SIL.
Design safe interfaces
Faults spread from one part of a system to another through interfaces, so the interface is where containment either works or fails. The rules below apply to a function call between software modules as much as to a message between two devices:
Make the contract explicit. Each input has a type, a unit, a range and a validity flag. “Speed in km/h, 0–500, invalid when the sensor reports a fault” is a contract; “an integer” is not.
Validate on the safety-related side. The receiver of higher integrity checks what it gets from a component of lower integrity. It never trusts the sender to have done so.
No silent defaults. A missing or invalid value must be reported as such. It must not be replaced by zero, the last value or a “typical” value that the caller cannot tell apart from real data.
Keep the interface narrow. The fewer operations and parameters a safety-related component exposes, the fewer ways other software can misuse it and the less there is to verify.
These rules are the system-level version of defensive programming. They also make the interfaces testable, because every range limit and invalid case becomes an obvious test case.
Keep it simple
Complexity is a major source of systematic failures. EN 50128 and IEC 61508-3 recommend techniques such as modular design, limited use of dynamic features, coding standards, defensive programming and static analysis, with stronger recommendations at higher SILs.
In my experience the most effective simplification happens at the requirements level. A safety function that is small, clearly specified and isolated is easier to design, verify and argue in the safety case than one that is mixed into a large application.
Many engineers know resilience patterns from distributed systems: timeouts, retries, circuit breakers, fallbacks and observability. They are useful in safety-related systems too, but they were designed to keep a service available.
In a safety-related design, each one must be checked against the question: where does this lead when it triggers? The table maps each pattern to its safety-related counterpart.
Pattern
What it does
Safety-related counterpart
Caveat
Timeout
Bounds waiting time
Message timeout, watchdog
The timeout must fit within the FTTI
Retry
Repeats a failed operation
Limited repetition of a request
Retries add delay and may repeat a command
Circuit breaker
Stops calling a failing dependency
Isolating a faulty channel or input
The resulting state must be safe
Fallback
Returns a default result
Degraded mode
The default must be the restrictive value
Observability
Logs, metrics, traces
Diagnostic logs, event recorders
Recording must not interfere with the safety function
Fallbacks must be restrictive
A fallback that returns the “last known good” speed limit or a default “track clear” status turns a detected fault into a hidden hazard. In a safety-related function the fallback value is the most restrictive one, and the degraded mode must be covered by the hazard analysis.
Example: a safe message receiver
Safety-related communication over a network has to deal with corrupted, repeated, lost, delayed and reordered messages. EN 50159 lists these threats and the usual defences, such as sequence numbers, timestamps or timeouts, source and destination identifiers and a safety code.
The sketch below combines a few of them. It is illustrative, not production code.
#include <stdbool.h>#include <stdint.h>typedef struct { uint16_t source_id; uint32_t seq; uint32_t timestamp_ms; uint16_t speed_limit_kmh; uint32_t safety_code; /* e.g. CRC over the fields above */} SafeMsg;typedef struct { uint16_t expected_source; uint32_t last_seq; uint32_t last_valid_ms; uint16_t speed_limit_kmh; /* value used by the safety function */} Receiver;#define MSG_TIMEOUT_MS 500u /* illustrative; derived from the FTTI */#define SAFE_SPEED_KMH 0u /* most restrictive value */extern uint32_t compute_safety_code(const SafeMsg *m);static bool msg_is_valid(const Receiver *r, const SafeMsg *m){ return m->source_id == r->expected_source && m->seq > r->last_seq /* no repetition or reordering */ && m->safety_code == compute_safety_code(m);}void receiver_on_msg(Receiver *r, const SafeMsg *m, uint32_t now_ms){ if (msg_is_valid(r, m)) { r->last_seq = m->seq; r->last_valid_ms = now_ms; r->speed_limit_kmh = m->speed_limit_kmh; } /* invalid messages are ignored; the timeout below handles the rest */}void receiver_cycle(Receiver *r, uint32_t now_ms){ if ((uint32_t)(now_ms - r->last_valid_ms) > MSG_TIMEOUT_MS) { r->speed_limit_kmh = SAFE_SPEED_KMH; /* fail to the safe state */ }}
Note the two design choices:
An invalid message never updates the value used by the safety function.
A missing message is a fault with a defined reaction. After the timeout, the receiver falls back to the most restrictive value.
A real implementation would also handle sequence-number wrap-around, a delay check based on the timestamp and the start-up state, which here should also be the safe value.
Observability and evidence
You cannot fix what you cannot see, and you cannot argue safety without evidence. In safety-related systems, logging serves three purposes:
Diagnostics for maintenance, so that latent faults are found and repaired.
Event recording for investigation after an incident. ETCS, for example, includes a juridical recording function on board.
Evidence for verification and validation, showing that safety mechanisms triggered as designed during testing.
Logging code is usually not safety-related itself, so it must be separated from the safety function and must not be able to block it. For how to use recorded data after an event, see learning from incidents.
Common mistakes
Starting with patterns instead of hazards. Redundancy and watchdogs added without a hazard analysis protect against the wrong things.
Treating availability measures as safety measures. A retry or failover that keeps the function running can hide a fault that should have led to the safe state.
Assuming redundancy removes systematic faults. Identical channels share identical bugs. Use diversity or stronger process measures where the SIL requires it.
Forgetting the timing. A correct detection that arrives after the FTTI is a failed safety mechanism.
Ignoring common causes. Two layers sharing a power supply, a sensor or a requirement are not independent.
Testing only the happy path. Safety mechanisms must be tested by injecting the faults they are designed to catch. See testing failure modes.
Standards: EN 50126-1 and EN 50126-2, EN 50128, EN 50129, EN 50159, IEC 61508 (parts 1–7), ISO 26262
Bezpieczeństwa nie dokłada się pod koniec projektu. Jest cechą całego rozwiązania: architektury, wymagań, kodu i tego, jak system się zachowuje, gdy jego części ulegają uszkodzeniu.
W sterowaniu ruchem kolejowym, w elektronice pojazdowej i w wielu innych dziedzinach nie pyta się „czy to się zepsuje?”, tylko „co się stanie, kiedy to się zepsuje?”.
Piszę ten tekst dla inżynierów, którzy projektują lub oceniają systemy, w których uszkodzenie może zranić ludzi albo zniszczyć sprzęt. Przyda się też programistom, którzy znają wzorce odporności z systemów rozproszonych i chcą zobaczyć, jak mają się one do bezpieczeństwa funkcjonalnego.
Odwołuję się do norm kolejowych (EN 50126, EN 50128, EN 50129) oraz do IEC 61508 i ISO 26262, z którymi pracowałem przy projektach urządzeń srk i w motoryzacji.
Bezpieczeństwo to nie niezawodność
Niezawodność to zdolność obiektu do realizacji funkcji przez określony czas w określonych warunkach. Bezpieczeństwo to brak niedopuszczalnego ryzyka szkody. Oba pojęcia są ze sobą powiązane, ale potrafią ciągnąć w przeciwne strony.
Tabela zestawia oba punkty widzenia.
Aspekt
Perspektywa niezawodności
Perspektywa bezpieczeństwa
Główne pytanie
Jak często się psuje?
Jaką szkodę może wyrządzić uszkodzenie?
Dobry wynik
Funkcja działa dalej
System osiąga stan bezpieczny lub w nim pozostaje
Typowa miara
Intensywność uszkodzeń λ, MTTF, MTBF
Intensywność zagrożeń, THR, SIL
Typowa reakcja na uszkodzenie
Ponów, przełącz na rezerwę, działaj dalej
Wykryj, zareaguj, przejdź do stanu bezpiecznego
Przykładowy konflikt
Pociąg ma jechać dalej
W razie wątpliwości hamuj
Pociąg, który hamuje przy każdym wątpliwym odczycie czujnika, jest bezpieczny, ale zawodny i nikt go nie lubi. Pociąg, który ignoruje wątpliwe dane, żeby utrzymać rozkład, jest niezawodny – do dnia, w którym przestaje być bezpieczny.
Dobry projekt ma na oku oba cele. Dlatego EN 50126 ujmuje je razem jako RAMS (niezawodność, gotowość, podatność utrzymaniowa i bezpieczeństwo). Stronę ilościową opisuję w artykule MTTF, MTBF i THR.
Od zagrożeń do projektu
Projektowania związanego z bezpieczeństwem nie zaczyna się od wzorców, tylko od zagrożeń. Cykl życia według EN 50126 wygląda w uproszczeniu tak:
  +------------------+     +-------------------+     +---------------+
  | Identyfikacja    |---->| Analiza i ocena   |---->| Wymagania     |
  | zagrożeń         |     | ryzyka            |     | bezpieczeństwa|
  +------------------+     +-------------------+     | (THR, SIL)    |
                                                     +-------+-------+
                                                             |
  +------------------+     +-------------------+     +-------v-------+
  | Dowód            |<----| Weryfikacja       |<----| Architektura  |
  | bezpieczeństwa   |     | i walidacja       |     | i projekt     |
  | (EN 50129)       |     |                   |     |               |
  +------------------+     +-------------------+     +---------------+
Górny rząd czyta się od lewej do prawej, dolny – od prawej do lewej. Najpierw identyfikuje się zagrożenia i ocenia ich ryzyko.
Wynikiem są wymagania bezpieczeństwa, w tym dopuszczalna intensywność zagrożeń (THR) i poziom nienaruszalności bezpieczeństwa (SIL) dla każdej funkcji bezpieczeństwa. Następnie projektuje się architekturę, która je spełnia, weryfikuje się ją i waliduje, a dowody zbiera w dowodzie bezpieczeństwa (safety case).
Important
Każdą decyzję projektową opisaną dalej powinno dać się powiązać z konkretnym zagrożeniem i wymaganiem bezpieczeństwa. Zabezpieczenie, które nie odpowiada na żadne zidentyfikowane zagrożenie, to koszt i złożoność, a nie bezpieczeństwo.
Jako inżynier wymagań przekonałem się, że utrzymanie śledzenia powiązań (traceability) w tym łańcuchu – zagrożenie → wymaganie bezpieczeństwa → element projektu → test – w narzędziu takim jak IBM DOORS jest co najmniej tak samo ważne jak dowolny wzorzec projektowy. Luka w tym łańcuchu to luka w argumentacji bezpieczeństwa.
Podstawowe zasady
Zakładaj, że wszystko się psuje
Każdy komponent prędzej czy później ulegnie uszkodzeniu. Normy bezpieczeństwa rozróżniają dwa rodzaje uszkodzeń:
Losowe uszkodzenia sprzętu pojawiają się w nieprzewidywalnym momencie w wyniku fizycznej degradacji. Uwzględnia się je przez cele probabilistyczne, redundancję i diagnostykę.
Uszkodzenia systematyczne są wbudowane w system: błędne wymaganie, błąd projektowy, błąd w oprogramowaniu. Ujawniają się za każdym razem, gdy zajdą warunki wyzwalające, a przeciwdziała się im rygorem procesu (cykl życia, przeglądy, testy, kwalifikacja narzędzi) dobranym do SIL.
Redundancja pomaga na uszkodzenia losowe. Dwie identyczne kopie tego samego błędu w oprogramowaniu nie pomagają wcale.
Dlatego wyższe poziomy nienaruszalności bezpieczeństwa wymagają takich środków jak różnorodność, niezależna weryfikacja i ostrzejsze techniki wytwarzania (EN 50128, IEC 61508-3).
Określ stan bezpieczny
Żeby system mógł bezpiecznie ulec uszkodzeniu, trzeba najpierw wiedzieć, co dla niego znaczy „bezpiecznie”. Stan bezpieczny to stan, w którym zagrożenie nie może wystąpić albo jego ryzyko jest akceptowalne. Tabela pokazuje typowe przykłady.
System
Typowy stan bezpieczny
Komentarz
Semafor kolejowy
Najbardziej restrykcyjny sygnał (stój)
Fail-safe: zanik zasilania nie może dać sygnału zezwalającego
Urządzenia pokładowe ETCS
Hamowanie
Pociąg zostaje zatrzymany, a nadzór przywraca się później
Prasa przemysłowa
Ruch zatrzymany, osłona zablokowana
Osiągany przez odłączenie zasilania
Elektryczne wspomaganie kierownicy
Zależy od sytuacji
Samo wyłączenie może być zagrożeniem
Sterowanie lotem samolotu
W locie brak pasywnego stanu bezpiecznego
Wymaga projektu fail-operational
Ważne są dwa ostatnie wiersze. Nie każdy system ma pasywny stan bezpieczny.
Jeśli samo wyłączenie jest niebezpieczne, projekt musi być fail-operational: po uszkodzeniu system utrzymuje minimalną bezpieczną funkcję, zwykle dzięki redundancji, np. głosowaniu 2oo3.
Fail-safe
Projekt fail-safe to taki, w którym wiarygodne uszkodzenia komponentu popychają system w stronę stanu bezpiecznego. EN 50129 opisuje trzy sposoby osiągnięcia tej właściwości w elektronicznych systemach związanych z bezpieczeństwem. Każdy ma klasyczne przykłady w urządzeniach srk:
Zasada bezpieczeństwa wewnętrznego (inherent fail-safety). Wiarygodne rodzaje uszkodzeń samego komponentu są bezpieczne. Typowym przypadkiem jest zasada prądu spoczynkowego (obwodu zamkniętego): przerwany przewód, zanik zasilania czy uszkodzona cewka przekaźnika odcinają energię i system wraca do stanu restrykcyjnego.
Zasada bezpieczeństwa złożonego (composite fail-safety). Wyjście zezwalające pojawia się dopiero wtedy, gdy zgodzą się dwa kanały. Na tym opiera się architektura 2oo2: każda niezgodność prowadzi do stanu bezpiecznego.
Zasada bezpieczeństwa reaktywnego (reactive fail-safety). Pracuje jeden kanał, ale diagnostyka wykrywa uszkodzenia dostatecznie szybko, a reakcja na czas doprowadza system do stanu bezpiecznego.
Ta sama myśl sprawdza się także poza systemami związanymi z bezpieczeństwem. Serwis płatności nie powinien obciążyć klienta dwa razy tylko dlatego, że po timeoucie żądanie zostało ponowione. Co jest wynikiem „bezpiecznym”, określa dziedzina, a projekt (tutaj idempotentne żądania) to wymusza.
Fail-safe to nie „psuje się po cichu”
Komponent, który przestaje wysyłać komunikaty, jest fail-safe tylko wtedy, gdy odbiorca zauważy ciszę i zareaguje. Utrata komunikacji sama w sobie musi być wykrywanym uszkodzeniem z określoną reakcją.
Wykrywaj i reaguj na czas
Samo wykrycie nie wystarczy, jeśli reakcja przychodzi za późno. Czas od uszkodzenia do osiągnięcia stanu bezpiecznego musi być krótszy niż czas, w którym uszkodzenie może przerodzić się w zagrożenie.
ISO 26262 nazywa ten czas fault tolerant time interval (FTTI). IEC 61508 używa w podobnym znaczeniu pojęcia czasu bezpieczeństwa procesu (process safety time).
FDTI + FRTI ≤ FTTIFDTI = fault detection time interval (h, s lub ms)FRTI = fault reaction time intervalFTTI = fault tolerant time interval
Wzór 1 – Warunek czasowy dla mechanizmu bezpieczeństwa (pojęcia z ISO 26262)
Typowe mechanizmy wykrywania to:
Watchdogi, które wykrywają zawieszony lub zatrzymany program.
Kontrole wiarygodności i zakresu wejść, np. porównanie wskazań dwóch niezależnych czujników prędkości.
Porównanie krzyżowe między redundantnymi kanałami.
Okresowe autotesty pamięci, procesora i wejść/wyjść.
Kontrola aktualności i integralności komunikatów.
Udział niebezpiecznych uszkodzeń wykrywanych przez diagnostykę to pokrycie diagnostyczne (diagnostic coverage). W IEC 61508 wchodzi ono wprost do metryk sprzętowych dla danego SIL, a w dowodzie bezpieczeństwa według EN 50129 decyduje o tym, jak szybko uszkodzenia zostaną wykryte. To ilościowy parametr projektu, a nie mglisty cel jakościowy.
Obrona w głąb
Żadne pojedyncze zabezpieczenie nie jest doskonałe, dlatego stosuje się kilka niezależnych warstw. Każda powinna wyłapać to, co przepuściła poprzednia, a warstwy nie powinny mieć wspólnej przyczyny uszkodzenia.
  przyczyna zagrożenia
       |
       v
  +---------------------------------------------------+
  | 1. Zapobieganie: poprawne wymagania, rygorystyczny|
  |    proces, prosty projekt                         |
  +---------------------------------------------------+
       |  pozostałe błędy
       v
  +---------------------------------------------------+
  | 2. Wykrywanie: diagnostyka, kontrole              |
  |    wiarygodności, watchdogi, porównanie krzyżowe  |
  +---------------------------------------------------+
       |  wykryte uszkodzenia
       v
  +---------------------------------------------------+
  | 3. Reakcja: przejście do stanu bezpiecznego       |
  +---------------------------------------------------+
       |  reakcja zawodzi lub jest spóźniona
       v
  +---------------------------------------------------+
  | 4. Łagodzenie: niezależne zabezpieczenie, przepisy|
  |    eksploatacyjne, ograniczanie skutków           |
  +---------------------------------------------------+
Diagram pokazuje cztery warstwy. Błąd, który prześlizgnie się przez warstwę zapobiegania, powinien zostać wykryty, a wykryte uszkodzenie powinno doprowadzić do stanu bezpiecznego. Jeśli ta reakcja zawiedzie, skutki ogranicza niezależna warstwa.
Kluczowe jest słowo niezależna. Dwie warstwy, które działają na tym samym procesorze, korzystają z tego samego czujnika albo powstały na podstawie tego samego błędnego wymagania, mogą zawieść jednocześnie. Sprawdza się to analizą uszkodzeń spowodowanych wspólną przyczyną (CCF).
Izoluj uszkodzenia
Uszkodzenie w jednej części systemu nie powinno przenosić się na inne. W systemach związanych z bezpieczeństwem mówi się tu często o braku wzajemnego oddziaływania (freedom from interference, ISO 26262) albo o separacji funkcji o różnych poziomach nienaruszalności.
W praktyce stosuje się:
Partycjonowanie w czasie i pamięci, np. za pomocą jądra separacyjnego lub RTOS z partycjami.
Oddzielenie funkcji związanych z bezpieczeństwem od pozostałych, tak aby błąd w kodzie wyświetlającym diagnostykę nie mógł zepsuć logiki hamowania.
Ściśle zdefiniowane interfejsy z walidacją wejść na każdej granicy między poziomami nienaruszalności.
Izolacja pozwala też utrzymać dowód bezpieczeństwa w rozsądnych rozmiarach. Jeśli oprogramowanie niezwiązane z bezpieczeństwem nie może wpływać na funkcję bezpieczeństwa, nie trzeba go wytwarzać według tego samego SIL.
Projektuj bezpieczne interfejsy
Uszkodzenia przenoszą się między częściami systemu przez interfejsy, więc to na interfejsie izolacja albo działa, albo zawodzi. Poniższe zasady dotyczą wywołania funkcji między modułami oprogramowania w tym samym stopniu co komunikatu między dwoma urządzeniami:
Jawny kontrakt. Każde wejście ma typ, jednostkę, zakres i flagę ważności. „Prędkość w km/h, 0–500, nieważna, gdy czujnik zgłasza uszkodzenie” to kontrakt; „liczba całkowita” – nie.
Walidacja po stronie związanej z bezpieczeństwem. Odbiorca o wyższym poziomie nienaruszalności sprawdza to, co dostaje od komponentu o niższym poziomie. Nigdy nie zakłada, że zrobił to nadawca.
Żadnych cichych wartości domyślnych. Brakującą lub nieważną wartość trzeba zgłosić jako taką. Nie wolno jej zastępować zerem, ostatnią wartością ani „typową” wartością, której wywołujący nie odróżni od prawdziwych danych.
Wąski interfejs. Im mniej operacji i parametrów udostępnia komponent związany z bezpieczeństwem, tym mniej sposobów na jego niewłaściwe użycie i tym mniej do weryfikacji.
To nic innego jak programowanie defensywne przeniesione na poziom systemu. Przy okazji interfejsy stają się łatwe do testowania, bo każda granica zakresu i każdy przypadek nieważnej wartości to oczywisty przypadek testowy.
Upraszczaj
Złożoność jest jednym z głównych źródeł uszkodzeń systematycznych. EN 50128 i IEC 61508-3 zalecają m.in. projekt modułowy, ograniczone użycie mechanizmów dynamicznych, standardy kodowania, programowanie defensywne i analizę statyczną – im wyższy SIL, tym mocniej.
Z mojego doświadczenia najwięcej daje upraszczanie na poziomie wymagań. Małą, jasno wyspecyfikowaną i odizolowaną funkcję bezpieczeństwa łatwiej zaprojektować, zweryfikować i obronić w dowodzie bezpieczeństwa niż taką, która jest rozproszona po dużej aplikacji.
O tym, jak zmienia się kolejowa norma dotycząca oprogramowania, piszę w artykule EN 50128 a EN 50716.
Wzorce odporności z perspektywy bezpieczeństwa
Wielu inżynierów zna wzorce odporności z systemów rozproszonych: timeouty, ponowienia, circuit breakery, rozwiązania zastępcze (fallback) i obserwowalność. Przydają się także w systemach związanych z bezpieczeństwem, ale powstały po to, żeby usługa pozostała dostępna.
W projekcie związanym z bezpieczeństwem każdy z nich trzeba sprawdzić pod kątem jednego pytania: dokąd to prowadzi, kiedy zadziała? Tabela zestawia wzorce z ich odpowiednikami w systemach bezpieczeństwa.
Wzorzec
Co robi
Odpowiednik w systemach bezpieczeństwa
Zastrzeżenie
Timeout
Ogranicza czas oczekiwania
Timeout komunikatu, watchdog
Timeout musi mieścić się w FTTI
Ponowienie
Powtarza nieudaną operację
Ograniczone powtórzenie żądania
Wydłuża czas i może powtórzyć polecenie
Circuit breaker
Przestaje wywoływać niesprawną zależność
Odłączenie uszkodzonego kanału lub wejścia
Stan wynikowy musi być bezpieczny
Fallback
Zwraca wynik domyślny
Tryb zdegradowany
Wartość domyślna musi być najbardziej restrykcyjna
Obserwowalność
Logi, metryki, ślady
Logi diagnostyczne, rejestratory zdarzeń
Rejestracja nie może zakłócać funkcji bezpieczeństwa
Fallback musi być restrykcyjny
Fallback, który zwraca „ostatnie dobre” ograniczenie prędkości albo domyślny status „tor wolny”, zamienia wykryte uszkodzenie w ukryte zagrożenie. W funkcji związanej z bezpieczeństwem wartością zastępczą jest wartość najbardziej restrykcyjna, a tryb zdegradowany musi być objęty analizą zagrożeń.
Przykład: bezpieczny odbiornik komunikatów
Komunikacja związana z bezpieczeństwem w sieci musi sobie radzić z komunikatami przekłamanymi, powtórzonymi, utraconymi, opóźnionymi i przestawionymi. EN 50159 wymienia te zagrożenia i typowe środki obrony: numery sekwencyjne, znaczniki czasu lub timeouty, identyfikatory nadawcy i odbiorcy oraz kod bezpieczeństwa.
Poniższy szkic łączy kilka z nich. To przykład poglądowy, a nie kod produkcyjny.
#include <stdbool.h>#include <stdint.h>typedef struct { uint16_t source_id; uint32_t seq; uint32_t timestamp_ms; uint16_t speed_limit_kmh; uint32_t safety_code; /* np. CRC z powyższych pól */} SafeMsg;typedef struct { uint16_t expected_source; uint32_t last_seq; uint32_t last_valid_ms; uint16_t speed_limit_kmh; /* wartość używana przez funkcję bezpieczeństwa */} Receiver;#define MSG_TIMEOUT_MS 500u /* poglądowo; wyprowadzone z FTTI */#define SAFE_SPEED_KMH 0u /* wartość najbardziej restrykcyjna */extern uint32_t compute_safety_code(const SafeMsg *m);static bool msg_is_valid(const Receiver *r, const SafeMsg *m){ return m->source_id == r->expected_source && m->seq > r->last_seq /* bez powtórzeń i przestawień */ && m->safety_code == compute_safety_code(m);}void receiver_on_msg(Receiver *r, const SafeMsg *m, uint32_t now_ms){ if (msg_is_valid(r, m)) { r->last_seq = m->seq; r->last_valid_ms = now_ms; r->speed_limit_kmh = m->speed_limit_kmh; } /* nieważne komunikaty są ignorowane; resztą zajmuje się timeout poniżej */}void receiver_cycle(Receiver *r, uint32_t now_ms){ if ((uint32_t)(now_ms - r->last_valid_ms) > MSG_TIMEOUT_MS) { r->speed_limit_kmh = SAFE_SPEED_KMH; /* przejście do stanu bezpiecznego */ }}
Warto zwrócić uwagę na dwie decyzje projektowe:
Nieważny komunikat nigdy nie zmienia wartości używanej przez funkcję bezpieczeństwa.
Brak komunikatu to uszkodzenie z określoną reakcją. Po upływie timeoutu odbiornik przechodzi na wartość najbardziej restrykcyjną.
Prawdziwa implementacja musiałaby jeszcze obsłużyć przepełnienie licznika sekwencji, kontrolę opóźnienia na podstawie znacznika czasu i stan po uruchomieniu, który także powinien odpowiadać wartości bezpiecznej.
Obserwowalność i dowody
Nie naprawisz tego, czego nie widzisz, i nie wykażesz bezpieczeństwa bez dowodów. W systemach związanych z bezpieczeństwem rejestracja danych służy trzem celom:
Diagnostyce na potrzeby utrzymania – żeby uszkodzenia ukryte zostały znalezione i usunięte.
Rejestracji zdarzeń na potrzeby badania incydentów. ETCS ma na przykład pokładową funkcję rejestracji prawnej (juridical recording).
Dowodom na potrzeby weryfikacji i walidacji – pokazują, że mechanizmy bezpieczeństwa zadziałały w testach zgodnie z projektem.
Kod rejestrujący zwykle sam nie jest związany z bezpieczeństwem, więc musi być oddzielony od funkcji bezpieczeństwa i nie może jej blokować. Jak wykorzystać zarejestrowane dane po zdarzeniu, opisuję w artykule uczenie się na incydentach.
Typowe błędy
Zaczynanie od wzorców zamiast od zagrożeń. Redundancja i watchdogi dodane bez analizy zagrożeń chronią przed niewłaściwymi rzeczami.
Traktowanie środków dostępności jak środków bezpieczeństwa. Ponowienie lub przełączenie na rezerwę, które utrzymuje funkcję przy życiu, może zamaskować uszkodzenie, które powinno było doprowadzić do stanu bezpiecznego.
Przekonanie, że redundancja usuwa uszkodzenia systematyczne. Identyczne kanały mają identyczne błędy. Tam, gdzie wymaga tego SIL, stosuj różnorodność lub mocniejsze środki procesowe.
Zapominanie o czasie. Poprawne wykrycie, które przychodzi po upływie FTTI, oznacza, że mechanizm bezpieczeństwa zawiódł.
Pomijanie wspólnych przyczyn. Dwie warstwy, które dzielą zasilacz, czujnik albo wymaganie, nie są niezależne.
Testowanie tylko ścieżki pozytywnej. Mechanizmy bezpieczeństwa trzeba testować, wstrzykując uszkodzenia, które mają wykrywać. Więcej w artykule testowanie rodzajów uszkodzeń.
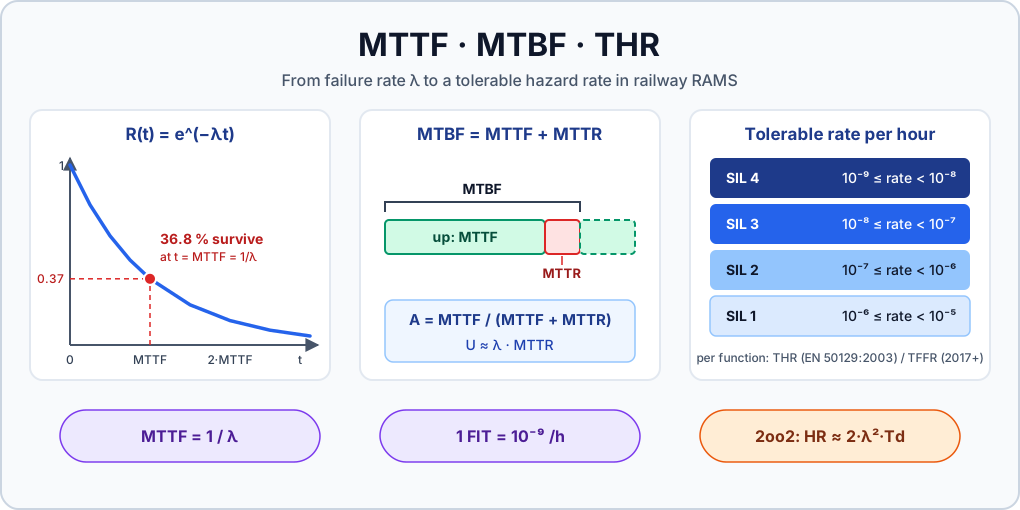
A practical guide to failure rate, FIT, MTTF, MTBF, MTTR, availability and Tolerable Hazard Rate (THR) in railway RAMS per EN 50126 and EN 50129, with step-by-step worked examples for series, redundant and 2oo2 fail-safe systemsPraktyczny przewodnik po intensywności uszkodzeń, FIT, MTTF, MTBF, MTTR, gotowości i dopuszczalnej intensywności zagrożeń (THR) w kolejowym RAMS wg EN 50126 i EN 50129, z przykładami obliczeń krok po kroku dla układów szeregowych, redundantnych i bezpiecznych układów 2oo2
A practical guide to EN 50126-1/-2:2017: the 12-phase RAMS lifecycle, hazard log, CSM-RA-aligned risk acceptance, roles, independent safety assessment and THR/TFFR/SIL apportionment.Praktyczny przewodnik po EN 50126-1/-2:2017: 12-fazowy cykl życia systemu, rejestr zagrożeń, zasady akceptacji ryzyka zgodne z CSM-RA, role, niezależna ocena bezpieczeństwa oraz podział THR/TFFR/SIL.
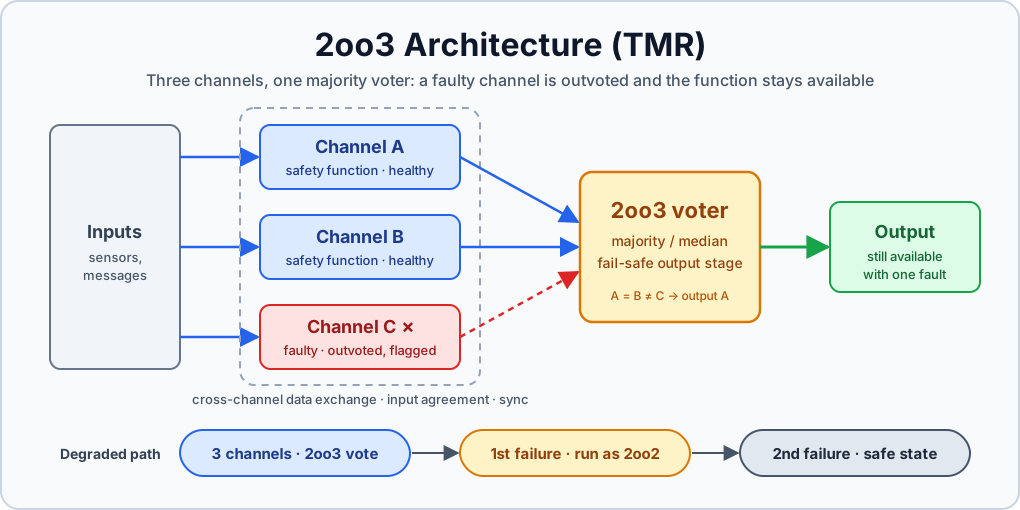
How 2oo3 (TMR) voting works, how to design the voter, what happens after the first channel failure, and how 2oo3 compares with 2oo2 and 1oo2 using IEC 61508-6 PFD/PFH formulas.Jak działa głosowanie 2oo3 (TMR), jak zaprojektować układ głosujący, co się dzieje po pierwszym uszkodzeniu kanału i jak 2oo3 wypada na tle 2oo2 i 1oo2 według wzorów PFD/PFH z IEC 61508-6.