Learning from Incidents: Blameless Reviews and Railway InvestigationUczenie się na incydentach: przeglądy bez szukania winnych i badanie wypadków kolejowych
What blameless post-mortems have in common with railway accident investigation: independent investigation bodies, the Railway Safety Directive, systemic causes and feeding lessons back into safety engineering.Co łączy post-mortemy bez szukania winnych z badaniem wypadków kolejowych: niezależne komisje badania wypadków, dyrektywa w sprawie bezpieczeństwa kolei, przyczyny systemowe i przenoszenie wniosków do inżynierii bezpieczeństwa.
Every engineering team has incidents. Some end as a short outage, others as a near miss on a test track. What the team does afterwards decides whether the same thing happens again.
In software operations this practice is usually called a blameless post-mortem. In the railway sector the same ideas have been developed for decades under the name of accident and incident investigation, with independent bodies, legal rules and published reports.
This article is for:
engineers and team leads who run incident reviews;
anyone in a safety-related domain who wants to connect software-industry practice with the way railways investigate accidents.
I do not describe specific accidents here. The aim is to explain the principles and how they fit into safety engineering.
What blameless means, and what it does not
A blameless review starts from one assumption: the people involved acted in a way that made sense to them at the time, given what they knew, the tools they had and the pressure they were under. The question is not “who caused this?” but “why did this action make sense, and why did the system not catch it?”.
Blameless does not mean that nobody is responsible. The table shows the difference between a blame-focused review, a blameless review and the related idea of a just culture.
Aspect
Blame-focused review
Blameless review
Just culture
Main question
Who made the mistake?
What conditions made it possible?
Was the behaviour acceptable in the circumstances?
Typical outcome
Discipline, retraining one person
System changes
System changes, sanctions only for reckless or wilful acts
Effect on reporting
People hide errors and near misses
People report openly
People report openly and trust the line between the two
Accountability
Backward-looking, personal
Forward-looking, for the improvements
Both, with a clear and fair boundary
Most safety-related organisations aim for a just culture. Honest mistakes are treated as information about the system, while gross negligence and deliberate violations remain unacceptable.
The boundary must be clear and applied consistently, otherwise “blameless” turns into “careful what you say”.
Important
The value of an incident review depends on the information people are willing to share. Anything that makes them less willing, including a review that later feeds a disciplinary process, reduces what the organisation can learn.
How railways investigate accidents
Railways are a good model because they separate learning from blame by design, and they do it at the level of law.
Independent national investigation bodies
In the European Union, the Railway Safety Directive (Directive (EU) 2016/798, which recast the earlier Directive 2004/49/EC) requires each Member State to have a permanent national investigation body (NIB).
The NIB must be independent of railway undertakings, infrastructure managers, the safety authority and anyone whose interests could conflict with its task.
The key principles are:
The NIB investigates serious accidents, and it may also investigate other accidents and incidents that under slightly different conditions could have led to a serious accident.
The investigation aims at improving railway safety and preventing accidents. It is not concerned with apportioning blame or liability, and it is kept separate from any judicial inquiry.
The result is a published report with safety recommendations, addressed mainly to the national safety authority and, where needed, to other bodies. The addressees are expected to report back on the measures they take.
In Poland this role is held by the Państwowa Komisja Badania Wypadków Kolejowych (PKBWK, State Commission on Railway Accident Investigation). In Great Britain it is the Rail Accident Investigation Branch (RAIB).
Their reports are public, and reading a few of them is one of the best ways to learn how systemic causes are analysed in practice.
The role of ERA
The European Union Agency for Railways (ERA) supports the network of national investigation bodies. It also maintains European railway safety information, including links to published investigation reports.
ERA also prepares the common safety methods (CSMs), which the European Commission adopts. The CSM on safety management system requirements expects railway undertakings and infrastructure managers to:
learn from accidents, incidents and near misses;
consider human and organisational factors;
take safety culture into account.
Note
The NIB investigation is separate from the internal investigation that a railway undertaking or infrastructure manager carries out under its own safety management system. Both should learn, but only the NIB is independent by law.
What software teams can take from this
The table maps elements of railway accident investigation to their counterparts in a product team’s post-incident review.
Railway investigation
Software or product post-mortem
Independent body, separate from the operator
A facilitator who was not involved in the incident
No apportioning of blame or liability
Blameless review, ideally a just culture
Investigates near misses, not only accidents
Review near misses and “lucky” events, not only outages
Published report with safety recommendations
Written report with tracked actions
Addressees report on the measures taken
Action owners report back, actions are closed with evidence
Juridical recording unit (JRU) and event logs
Logs, metrics, traces and diagnostic records
Looking for causes, not culprits
Beyond “human error”
“Human error” is where an analysis should start, not where it ends.
A driver who misreads a signal, an engineer who deploys the wrong configuration or a maintainer who skips a step all acted inside a system: an interface, a procedure, a schedule, a level of training and a set of expectations.
If those conditions stay the same, the next person will make the same mistake.
Typical contributing factors include:
information that was missing, ambiguous or presented badly at the time of the decision;
time pressure or conflicting goals, such as punctuality against caution;
interfaces and procedures that make the wrong action easy and the right one hard;
automation that behaved in a way the operator did not expect;
communication gaps between teams, shifts or organisations.
Protection layers and the Swiss cheese model
James Reason’s Swiss cheese model describes an accident as a moment when the holes in several protection layers line up. Each layer (design, procedures, training, supervision, technical protection) has weaknesses, and an accident happens only when they coincide.
A good investigation asks, for every layer: why did this one not stop the event? The answers usually point to several improvements rather than one “root cause”.
Root cause analysis methods
The table compares common methods of root cause analysis. None of them is required by the Railway Safety Directive. They are tools to structure the analysis.
Method
What it does
Strength
Limitation
Timeline / sequence of events
Reconstructs what happened and when
Builds a shared, factual picture
Shows what, not why
5 Whys
Asks “why?” repeatedly from the event
Quick, easy to teach
Tends to a single linear cause
Ishikawa (fishbone) diagram
Groups causes by category
Broadens the search
Does not show interactions
Fault tree analysis (FTA)
Breaks the event into combinations of causes
Shows AND/OR logic, links to safety analysis
Needs a well-defined top event
Systemic methods (e.g. AcciMap, CAST)
Analyse control and organisational structure
Captures organisational and regulatory factors
Need more time and training
One root cause is rarely the whole story
Root cause analysis is a useful name, but complex systems rarely fail for a single reason. If your analysis ends with one cause, and that cause is a person, go back and ask why the other layers did not catch it.
Running a post-incident review
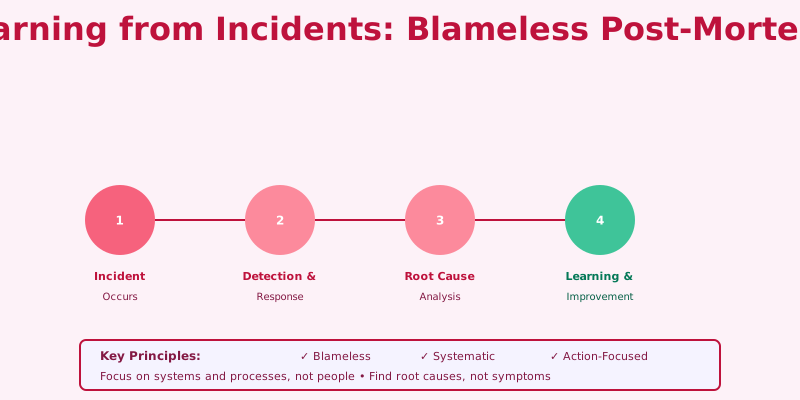
A practical sequence that works for engineering teams:
Secure the data. Save logs, recorder data, configuration and versions before they are overwritten.
Build the timeline. Facts first, with sources, without judgement.
Understand the decisions. For each key action, ask what the person knew and why it made sense to them.
Identify contributing factors at every protection layer: design, process, tools, organisation.
Agree on actions that change the system, each with an owner and a due date.
Publish and follow up. Share the report widely and close each action with evidence that it was implemented.
  +----------+    +-----------+    +-----------+    +-----------+
  | Incident |--->| Review    |--->| Findings  |--->| Actions   |
  | or near  |    | timeline, |    | factors   |    | owner,    |
  | miss     |    | decisions |    | per layer |    | due date  |
  +----------+    +-----------+    +-----------+    +-----+-----+
       ^                                                  |
       |    +---------------------------------------+     |
       +----| Changed system: hazard log, reqs,     |<----+
            | FMEA, tests, procedures, training     |
            +---------------------------------------+
The diagram shows the review as a loop:
An incident or near miss leads to a review.
The review produces findings for each protection layer.
The findings become actions, and the actions change the system.
The loop is closed only when the changed system is in place.
Closing the loop in safety engineering
In a safety-related project a review is not finished when the report is written. Its findings belong in the safety engineering artefacts:
Hazard log. Is the hazard already recorded? If not, add it. If yes, were the assumed causes and the risk evaluation correct? See CENELEC EN 50126.
Requirements. Missing or ambiguous safety requirements are a common contributing factor. Fix them at the source and keep the traceability.
FMEA and FTA. A failure mode that occurred but was not in the analysis means the analysis has a gap.
Tests. Add a test that reproduces the failure mode, ideally as a fault injection test. See testing failure modes.
As a requirements engineer I have found that the most durable improvements came from changes at the requirements and analysis level, because they reach every future version of the product, not only the one that failed.
Common mistakes
Stopping at “human error”. It names the symptom, not the cause.
Mixing learning with discipline. If the review can lead to sanctions for honest mistakes, people stop reporting.
Reviewing only big incidents. Near misses carry the same lessons at a much lower cost.
Actions without owners or evidence. An action that is never closed changes nothing.
Keeping the report private. Other teams and projects often have the same weakness.
Not updating the safety artefacts. If the hazard log, requirements and tests stay the same, the lesson stays in people’s heads only.
James Reason, Managing the Risks of Organizational Accidents, 1997
Sidney Dekker, The Field Guide to Understanding ‘Human Error’
Incydenty zdarzają się w każdym zespole inżynierskim. Czasem kończy się na krótkiej przerwie w działaniu systemu, czasem na zdarzeniu potencjalnie niebezpiecznym na torze doświadczalnym. To, co zespół zrobi potem, decyduje, czy sytuacja się powtórzy.
W branży IT taką analizę nazywa się zwykle post-mortemem bez szukania winnych (blameless post-mortem). Kolej rozwija te same idee od dziesięcioleci pod nazwą badania wypadków i incydentów – z niezależnymi organami, przepisami prawa i publikowanymi raportami.
Ten artykuł jest dla:
inżynierów i liderów zespołów, którzy prowadzą przeglądy incydentów;
wszystkich, którzy pracują przy systemach związanych z bezpieczeństwem i chcą zestawić praktykę z branży oprogramowania ze sposobem, w jaki kolej bada wypadki.
Nie opisuję tu konkretnych wypadków. Chcę wyjaśnić zasady i pokazać, jak wpisują się w inżynierię bezpieczeństwa.
Co znaczy „bez szukania winnych”, a czego nie znaczy
Przegląd bez szukania winnych zaczyna się od jednego założenia: uczestnicy zdarzenia postępowali w sposób, który w tamtej chwili wydawał im się sensowny. Wynikało to z ich wiedzy, dostępnych narzędzi i presji, pod jaką pracowali. Nie pytamy więc „kto to zrobił?”, tylko „dlaczego to działanie wydawało się słuszne i dlaczego system go nie wychwycił?”.
Rezygnacja z szukania winnych nie oznacza, że nikt za nic nie odpowiada. Tabela pokazuje różnicę między przeglądem nastawionym na winnych, przeglądem bez szukania winnych i pokrewną ideą kultury sprawiedliwego traktowania (just culture).
Aspekt
Przegląd nastawiony na winnych
Przegląd bez szukania winnych
Kultura sprawiedliwego traktowania
Główne pytanie
Kto popełnił błąd?
Jakie warunki go umożliwiły?
Czy zachowanie było do przyjęcia w tych okolicznościach?
Typowy wynik
Kara, dodatkowe szkolenie jednej osoby
Zmiany w systemie
Zmiany w systemie, sankcje tylko za lekkomyślność lub działanie umyślne
Wpływ na zgłaszanie
Ludzie ukrywają błędy i zdarzenia potencjalnie niebezpieczne
Ludzie zgłaszają otwarcie
Ludzie zgłaszają otwarcie i ufają, że granica jest uczciwa
Odpowiedzialność
Za przeszłość, osobista
Za przyszłe usprawnienia
Jedna i druga, z jasną i uczciwą granicą
Większość organizacji pracujących przy systemach związanych z bezpieczeństwem dąży do kultury sprawiedliwego traktowania. Uczciwe pomyłki traktuje się jako informację o systemie, ale rażące niedbalstwo i świadome naruszenia pozostają niedopuszczalne.
Granica musi być jasna i stosowana konsekwentnie. Inaczej „bez szukania winnych” szybko zamienia się w „uważaj, co mówisz”.
Important
Przegląd incydentu jest tyle wart, ile informacji ludzie są gotowi przekazać. Wszystko, co tę gotowość zmniejsza – także przegląd, którego wyniki trafiają potem do postępowania dyscyplinarnego – ogranicza to, czego organizacja może się nauczyć.
Jak kolej bada wypadki
Kolej jest dobrym wzorem, bo z założenia oddziela wyciąganie wniosków od szukania winnych – i to na poziomie prawa.
Niezależne krajowe organy dochodzeniowe
W Unii Europejskiej dyrektywa w sprawie bezpieczeństwa kolei (dyrektywa (UE) 2016/798, wersja przekształcona wcześniejszej dyrektywy 2004/49/WE) wymaga, by każde państwo członkowskie miało stały krajowy organ dochodzeniowy (national investigation body, NIB).
Organ ten musi być niezależny od przedsiębiorstw kolejowych, zarządców infrastruktury, krajowego organu ds. bezpieczeństwa i wszystkich, których interesy mogłyby kolidować z jego zadaniami.
Najważniejsze zasady:
NIB bada poważne wypadki. Może też badać inne wypadki i incydenty, które w nieco innych okolicznościach mogłyby doprowadzić do poważnego wypadku.
Celem postępowania jest poprawa bezpieczeństwa i zapobieganie wypadkom. Nie służy ono ustalaniu winy ani odpowiedzialności i toczy się niezależnie od postępowań sądowych.
Wynikiem jest publiczny raport z zaleceniami w zakresie bezpieczeństwa, kierowanymi głównie do krajowego organu ds. bezpieczeństwa, a w razie potrzeby także do innych podmiotów. Adresaci informują o podjętych działaniach.
W Polsce tę rolę pełni Państwowa Komisja Badania Wypadków Kolejowych (PKBWK). W Wielkiej Brytanii jest to Rail Accident Investigation Branch (RAIB).
Raporty obu instytucji są jawne. Lektura kilku z nich to jeden z najlepszych sposobów, by zobaczyć, jak w praktyce analizuje się przyczyny systemowe.
Rola ERA
Agencja Kolejowa Unii Europejskiej (ERA) wspiera sieć krajowych organów dochodzeniowych. Prowadzi też europejskie zasoby informacji o bezpieczeństwie kolei, w tym odnośniki do opublikowanych raportów z postępowań.
ERA przygotowuje również wspólne metody oceny bezpieczeństwa (CSM), które przyjmuje Komisja Europejska. CSM dotycząca wymagań dla systemu zarządzania bezpieczeństwem oczekuje od przedsiębiorstw kolejowych i zarządców infrastruktury, że będą:
wyciągać wnioski z wypadków, incydentów i zdarzeń potencjalnie niebezpiecznych;
uwzględniać czynniki ludzkie i organizacyjne;
brać pod uwagę kulturę bezpieczeństwa.
Note
Postępowanie NIB to coś innego niż wewnętrzne postępowanie, które przewoźnik lub zarządca infrastruktury prowadzi w ramach własnego systemu zarządzania bezpieczeństwem. Oba powinny służyć wyciąganiu wniosków, ale tylko NIB jest niezależny z mocy prawa.
Czego mogą się z tego nauczyć zespoły programistyczne
Tabela zestawia elementy badania wypadków kolejowych z ich odpowiednikami w przeglądzie po incydencie w zespole produktowym.
Badanie wypadków kolejowych
Post-mortem oprogramowania lub produktu
Niezależny organ, oddzielony od przewoźnika
Moderator, który nie brał udziału w incydencie
Bez ustalania winy i odpowiedzialności
Przegląd bez szukania winnych, najlepiej w kulturze sprawiedliwego traktowania
Bada zdarzenia potencjalnie niebezpieczne, nie tylko wypadki
Analizuj sytuacje „o włos” i te, które skończyły się szczęśliwie, nie tylko awarie
Publiczny raport z zaleceniami w zakresie bezpieczeństwa
Pisemny raport ze śledzonymi działaniami
Adresaci informują o podjętych działaniach
Właściciele działań raportują postęp, a działania zamyka się z dowodem
Rejestrator JRU (Juridical Recording Unit) i rejestry zdarzeń
Logi, metryki, ślady (traces) i zapisy diagnostyczne
Szukaj przyczyn, nie winnych
Głębiej niż „błąd ludzki”
„Błąd ludzki” to miejsce, w którym analiza powinna się zaczynać, a nie kończyć.
Maszynista, który źle odczyta wskazanie semafora, inżynier, który wdroży niewłaściwą konfigurację, czy pracownik utrzymania, który pominie krok procedury – każdy z nich działał wewnątrz systemu. Na ten system składają się interfejs, procedura, harmonogram, poziom wyszkolenia i oczekiwania otoczenia.
Jeśli te warunki się nie zmienią, następna osoba popełni ten sam błąd.
Typowe czynniki sprzyjające to:
informacja, której brakowało, była niejednoznaczna lub źle podana w chwili podejmowania decyzji;
presja czasu lub sprzeczne cele, np. punktualność kontra ostrożność;
interfejsy i procedury, w których łatwo zrobić źle, a trudno dobrze;
automatyka, która zachowała się inaczej, niż oczekiwał operator;
luki w komunikacji między zespołami, zmianami lub organizacjami.
Warstwy ochrony i model sera szwajcarskiego
Model sera szwajcarskiego Jamesa Reasona przedstawia wypadek jako chwilę, w której dziury w kilku warstwach ochrony ustawiają się w jednej linii. Każda warstwa (projekt, procedury, szkolenie, nadzór, zabezpieczenia techniczne) ma słabe punkty, a do wypadku dochodzi dopiero wtedy, gdy się one nałożą.
Dobre badanie zadaje przy każdej warstwie to samo pytanie: dlaczego ta warstwa nie zatrzymała zdarzenia? Odpowiedzi zwykle prowadzą do kilku usprawnień, a nie do jednej „przyczyny źródłowej”.
Metody analizy przyczyn źródłowych
Tabela porównuje popularne metody analizy przyczyn źródłowych. Dyrektywa w sprawie bezpieczeństwa kolei nie wymaga żadnej z nich. To narzędzia, które porządkują analizę.
Metoda
Co robi
Zaleta
Ograniczenie
Oś czasu / sekwencja zdarzeń
Odtwarza, co się stało i kiedy
Daje wspólny obraz oparty na faktach
Pokazuje co, a nie dlaczego
5 x Dlaczego (5 Whys)
Wielokrotnie pyta „dlaczego?”, zaczynając od zdarzenia
Szybka, łatwo jej nauczyć
Prowadzi do jednej, liniowej przyczyny
Diagram Ishikawy (rybiej ości)
Grupuje przyczyny w kategorie
Poszerza pole poszukiwań
Nie pokazuje interakcji
Analiza drzewa niezdatności (FTA)
Rozkłada zdarzenie na kombinacje przyczyn
Pokazuje logikę AND/OR, łączy się z analizą bezpieczeństwa
Wymaga dobrze zdefiniowanego zdarzenia szczytowego
Metody systemowe (np. AcciMap, CAST)
Analizują strukturę sterowania i organizacji
Obejmują czynniki organizacyjne i regulacyjne
Wymagają więcej czasu i przeszkolenia
Jedna przyczyna źródłowa rzadko wyjaśnia wszystko
Analiza przyczyn źródłowych to wygodna nazwa, ale złożone systemy rzadko zawodzą z jednego powodu. Jeśli analiza kończy się na jednej przyczynie, a tą przyczyną jest człowiek, wróć i zapytaj, dlaczego pozostałe warstwy jej nie wychwyciły.
Jak przeprowadzić przegląd po incydencie
Ta kolejność kroków sprawdza się w zespołach inżynierskich:
Zabezpiecz dane. Zachowaj logi, dane z rejestratorów, konfigurację i wersje, zanim zostaną nadpisane.
Odtwórz oś czasu. Najpierw fakty ze źródłami, bez ocen.
Zrozum decyzje. Przy każdym kluczowym działaniu ustal, co dana osoba wiedziała i dlaczego takie działanie wydawało jej się słuszne.
Wskaż czynniki sprzyjające w każdej warstwie ochrony: w projekcie, procesie, narzędziach i organizacji.
Uzgodnij działania, które zmieniają system – każde z właścicielem i terminem.
Opublikuj raport i pilnuj realizacji. Udostępnij raport szeroko i zamykaj każde działanie dowodem wdrożenia.
Incydent lub zdarzenie potencjalnie niebezpieczne uruchamia przegląd.
Przegląd daje wnioski dla każdej warstwy ochrony.
Wnioski zamieniają się w działania, a działania zmieniają system.
Pętla zamyka się dopiero wtedy, gdy zmieniony system faktycznie działa.
Zamykanie pętli w inżynierii bezpieczeństwa
W projekcie związanym z bezpieczeństwem przegląd nie kończy się na napisaniu raportu. Jego wnioski muszą trafić do dokumentacji bezpieczeństwa:
Rejestr zagrożeń. Czy to zagrożenie jest już w rejestrze? Jeśli nie, dopisz je. Jeśli tak, sprawdź, czy przyjęte przyczyny i ocena ryzyka były trafne. Zob. CENELEC EN 50126.
Wymagania. Brakujące lub niejednoznaczne wymagania bezpieczeństwa to częsty czynnik sprzyjający. Poprawiaj je u źródła i utrzymuj śledzenie powiązań (traceability).
FMEA i FTA. Jeśli wystąpił rodzaj uszkodzenia, którego nie było w analizie, analiza ma lukę.
Testy. Dodaj test, który odtwarza ten rodzaj uszkodzenia, najlepiej przez wstrzykiwanie uszkodzeń. Zob. testowanie rodzajów uszkodzeń.
Dane niezawodnościowe. Uszkodzenia z eksploatacji zasilają intensywności uszkodzeń używane w obliczeniach MTTF, MTBF i THR.
Jako inżynier wymagań przekonałem się, że najtrwalsze usprawnienia dawały zmiany w wymaganiach i analizach. Trafiają one do każdej kolejnej wersji produktu, a nie tylko do tej, która zawiodła.
Typowe błędy
Poprzestanie na „błędzie ludzkim”. To nazwa objawu, a nie przyczyna.
Mieszanie wyciągania wniosków z dyscypliną. Jeśli za uczciwą pomyłkę grożą sankcje, ludzie przestają zgłaszać.
Analizowanie tylko dużych incydentów. Zdarzenia potencjalnie niebezpieczne uczą tego samego znacznie mniejszym kosztem.
Działania bez właścicieli i dowodów. Działanie, którego nikt nie zamknie, niczego nie zmienia.
Chowanie raportu do szuflady. Inne zespoły i projekty często mają tę samą słabość.
Brak aktualizacji dokumentacji bezpieczeństwa. Jeśli rejestr zagrożeń, wymagania i testy się nie zmieniają, wiedza zostaje tylko w głowach ludzi.
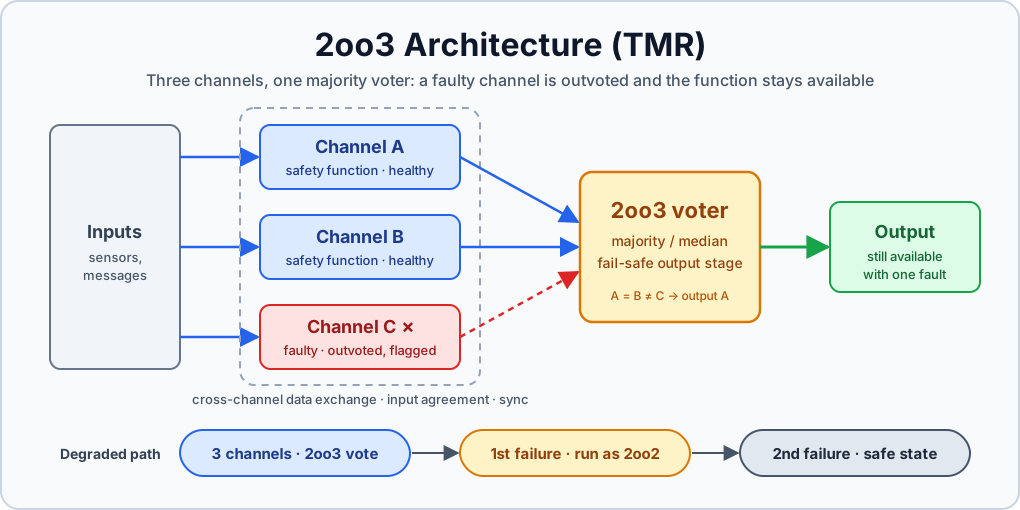
How 2oo3 (TMR) voting works, how to design the voter, what happens after the first channel failure, and how 2oo3 compares with 2oo2 and 1oo2 using IEC 61508-6 PFD/PFH formulas.Jak działa głosowanie 2oo3 (TMR), jak zaprojektować układ głosujący, co się dzieje po pierwszym uszkodzeniu kanału i jak 2oo3 wypada na tle 2oo2 i 1oo2 według wzorów PFD/PFH z IEC 61508-6.
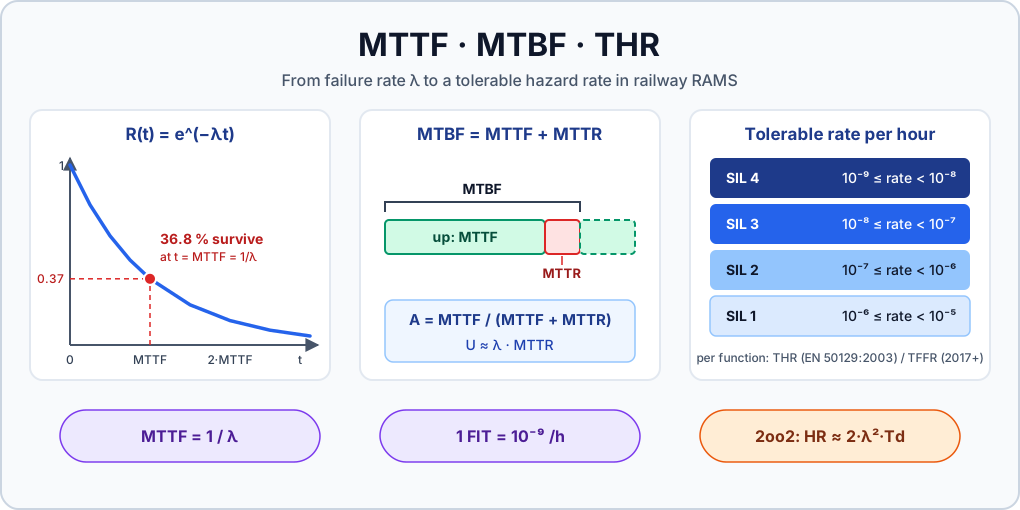
A practical guide to failure rate, FIT, MTTF, MTBF, MTTR, availability and Tolerable Hazard Rate (THR) in railway RAMS per EN 50126 and EN 50129, with step-by-step worked examples for series, redundant and 2oo2 fail-safe systemsPraktyczny przewodnik po intensywności uszkodzeń, FIT, MTTF, MTBF, MTTR, gotowości i dopuszczalnej intensywności zagrożeń (THR) w kolejowym RAMS wg EN 50126 i EN 50129, z przykładami obliczeń krok po kroku dla układów szeregowych, redundantnych i bezpiecznych układów 2oo2
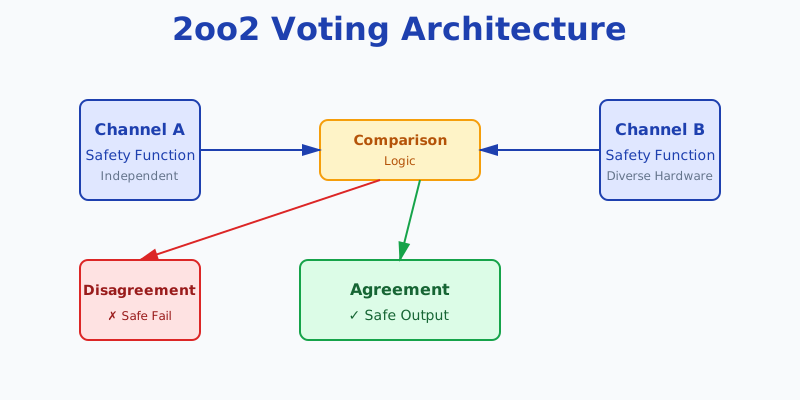
How 2oo2 composite fail-safe architectures work in railway signalling and safety computing: cross-checking, synchronisation, detection time, common-cause failures and the comparison with 2oo3.Jak działają architektury 2oo2 oparte na zasadzie bezpieczeństwa złożonego w urządzeniach srk: porównanie krzyżowe, synchronizacja, czas wykrycia, uszkodzenia spowodowane wspólną przyczyną i porównanie z 2oo3.