Testing Failure Modes: Fault Injection for Safety-Related SystemsTestowanie rodzajów uszkodzeń: wstrzykiwanie uszkodzeń w systemach bezpieczeństwa
How to test what happens when things break: FMEA-driven test cases, fault injection at software and hardware level, and how chaos engineering and property-based testing relate to EN 50128 and ISO 26262.Jak sprawdzić, co się dzieje, gdy coś się psuje: przypadki testowe wyprowadzone z FMEA, wstrzykiwanie uszkodzeń w oprogramowaniu i sprzęcie oraz miejsce inżynierii chaosu i testów opartych na właściwościach wobec EN 50128 i ISO 26262.
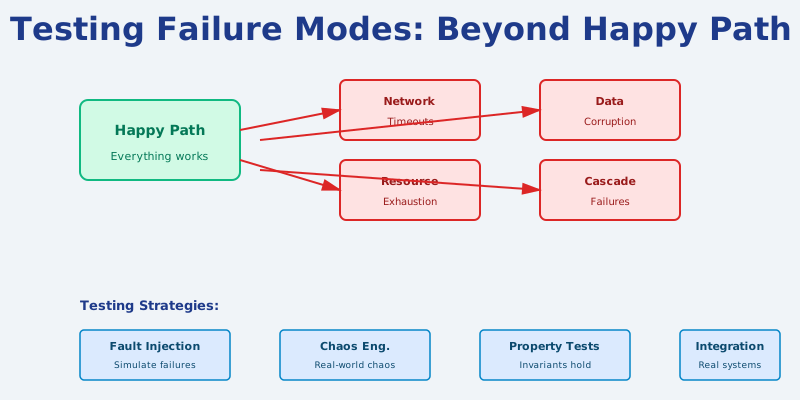
Most test suites concentrate on the happy path: valid inputs, working hardware and messages that arrive on time. In a safety-related system that is the least interesting part.
The safety argument rests on what the system does when a sensor sticks, a message is corrupted or a task overruns. Those situations do not occur on their own during a normal test campaign.
This article is for engineers who verify safety-related systems, and for software engineers who know fault injection from distributed systems and want to see how it maps to functional safety.
I refer to EN 50128 and EN 50129 for railway and to ISO 26262 for road vehicles. The design side of the same topic is covered in safety in system design.
Why the happy path is not enough
Safety mechanisms such as watchdogs, plausibility checks, cross-comparison and message timeouts do nothing while everything works. They are dormant code and dormant hardware, and dormant parts are exactly where latent faults hide.
There are three reasons to test them deliberately:
Evidence for the safety case. The safety case claims that certain faults are detected and lead to the safe state. Verification has to show that this happens in the real implementation, not only on paper.
Diagnostic coverage. Hardware metrics in IEC 61508, EN 50129 and ISO 26262 depend on the share of dangerous failures that diagnostics detect. Fault injection is one of the ways to support the coverage values you claim.
Timing. A detection that arrives too late is a failed safety mechanism. Only a test with a real fault shows the actual detection and reaction time.
Important
The pass criterion of a failure mode test is not “the system kept working”. It is “the fault was detected, and the system reached the defined safe state within the required time”.
Which failure modes to test
The table below groups typical failure modes of an embedded safety-related system and the mechanisms that are expected to catch them.
Category
Example failure modes
Typical safety mechanism
Sensor and input
Stuck-at value, out of range, drift, noise, open or short circuit
Range and plausibility checks, comparison of redundant sensors
Safety code, sequence numbers, timeouts, source identifiers (EN 50159)
Timing and execution
Task overrun, stuck program, wrong program flow
Watchdog, program flow monitoring, deadline monitoring
Memory and processor
Bit flips in RAM, corrupted ROM, faulty ALU
Memory tests, CRC over code and data, CPU self-tests, ECC
Power and output
Supply dropout or brown-out, output stuck on
Voltage monitoring, output read-back, de-energise to trip
Data and configuration
Wrong or inconsistent configuration data
Data validation, checksums, independent data preparation checks
The communication row follows the threat list of EN 50159, which is the usual reference for safety-related communication in railway systems.
Distributed-systems engineers will recognise most of the other rows. They are the same failure modes as network timeouts, duplicated messages and resource exhaustion, only with a stricter required reaction.
From FMEA to test cases
A failure mode and effects analysis (FMEA) already contains most of what a fault injection test needs. Each row names a failure mode, its effect, how it is detected and how the system reacts. If the analysis claims a detection, the test campaign should show it.
  +--------------+    +------------------+    +------------------+
  | FMEA row     |--->| Safety mechanism |--->| Fault injection  |
  | failure mode |    | requirement      |    | test case        |
  | + effect     |    | (detect, react,  |    | (inject, observe |
  +--------------+    |  time limit)     |    |  safe state)     |
         ^            +------------------+    +--------+---------+
         |                                             |
         +-------------- test result ------------------+
                 (confirms or corrects the FMEA)
The diagram shows the loop. The FMEA leads to requirements for the safety mechanisms, those requirements lead to test cases, and the test results flow back.
If a test shows that a fault is not detected, or is detected too late, the FMEA was wrong. The safety argument has to be corrected, not only the code.
The table shows how one FMEA row becomes a test case. The values are illustrative.
FMEA field
Content
Test case element
Failure mode
Speed sensor A stuck at last value
Fault to inject: freeze sensor A output
Local effect
Measured speed no longer follows the real speed
Stimulus: change real speed (simulated)
Detection
Cross-check of sensor A against sensor B
Expected: discrepancy fault raised
Reaction
Safe state: brake command
Expected: brake command issued
Time requirement
Detection and reaction within the FTTI
Measured: time from injection to brake command
In my work with FMEA and FTA on safety-related railway systems, the most useful habit has been to keep this link explicit in the requirements tool: failure mode → safety requirement → test case → result.
A gap anywhere in that chain is a gap in the safety argument, and reviewers will find it.
Fault injection techniques
Faults can be injected at different levels. The closer the level is to the real system, the more realistic the test, but the harder it is to control and to repeat.
Level
How faults are injected
Good for
Model or simulation
Faults switched on in a model of the system or plant
Early checks of the safety concept and reaction times
Software unit
Stubs and mocks return errors, invalid values or late answers
Defensive code, error paths, input validation
Software integration
Corrupted variables or messages via test hooks or a debugger
Interfaces between components, end-to-end error handling
Hardware-in-the-loop
Signal simulators, bus error injection, pin-level faults
Diagnostics, timing, interaction of hardware and software
System
Disconnected cables, power interruptions, corrupted telegrams
Validation of the safety case on the real configuration
Software-implemented fault injection
At unit and integration level the simplest technique is to replace a dependency with a stub that misbehaves: it returns an error code, an out-of-range value or nothing at all. The test then checks that the component under test reacts as specified.
This is the same idea as mocking a failing HTTP client in a web service. The difference is the expected result: a defined safe reaction, not just “no crash”.
Test hooks that corrupt data at runtime are powerful, but they are extra code in the product. Keep them out of the released build or prove that they cannot be activated in operation.
Hardware and system-level injection
At hardware-in-the-loop and system level, faults are injected into real signals: a sensor input forced to a fixed value, a communication bus with corrupted frames, a supply voltage dip.
These tests show the real detection and reaction times, including the hardware and the operating system. A unit test cannot do that.
What the standards say
ISO 26262 lists fault injection testing among the methods for verifying hardware, software and the integrated system, with stronger recommendations at higher ASILs.
EN 50128 does not use the term chaos engineering, but its catalogue of techniques includes related ones, again selected according to the software integrity level:
Always check the technique tables in the edition of the standard that applies to your project. The names and recommendation levels differ between standards and editions.
Chaos engineering through a safety lens
Chaos engineering grew out of large internet services. Teams deliberately kill instances, add latency or cut network links in production to check that the service stays available.
The method is built around a hypothesis:
Define the normal “steady state”.
Predict that it will hold when a certain fault occurs.
Inject the fault and compare.
That hypothesis-driven structure is valuable for safety work too. The difference is in the hypothesis and in the environment.
Aspect
Chaos engineering (IT services)
Safety-related fault injection
Hypothesis
Service stays available under the fault
System detects the fault and reaches the safe state in time
Environment
Often production, with a limited blast radius
Lab, test bench, HIL rig or test track, never revenue service
Fault selection
Random or based on experience
Systematic, derived from FMEA, FTA and the hazard log
Success measure
Error rate and latency stay within limits
Detection, safe state and timing as specified
Evidence
Dashboards and post-mortems
Test specifications, reports and traceability for the safety case
Never inject faults into a system in safety-related operation
Injecting faults into a train, a vehicle or an interlocking in service relies on the very safety mechanisms you are trying to test. Do it in a controlled test environment with independent protection in place.
The useful lesson from chaos engineering is the attitude: assume that failure modes exist which nobody wrote into the FMEA, and look for them on purpose.
Random fault campaigns on a test bench can complement the systematic, FMEA-driven tests. Sometimes they reveal combinations that the analysis missed.
Property-based testing of safety properties
Example-based tests check single scenarios. Property-based testing states a property that must hold for all inputs and lets a tool generate many random inputs and event sequences to look for a counterexample.
Safety requirements are often already written as such properties:
“The output is never more permissive than the inputs allow.”
“An invalid message never changes the value used by the safety function.”
“If no valid message has arrived for longer than the timeout, the value is the safe value.”
The sketch below tests the last two properties on a Python model of the safe message receiver from safety in system design. It uses the Hypothesis library. It is a model-level example, not a test of the real C code.
from hypothesis import given, strategies as stSAFE_SPEED = 0 # most restrictive valueTIMEOUT_MS = 500class Receiver: def __init__(self): self.last_seq = 0 self.last_valid_ms = 0 self.speed = SAFE_SPEED def on_msg(self, seq, speed, code_ok, now): if code_ok and seq > self.last_seq: self.last_seq = seq self.last_valid_ms = now self.speed = speed def cycle(self, now): if now - self.last_valid_ms > TIMEOUT_MS: self.speed = SAFE_SPEED# One event: time step, sequence number, speed, safety code ok, deliveredevents = st.lists(st.tuples( st.integers(0, 2000), st.integers(0, 100), st.integers(0, 300), st.booleans(), st.booleans()))@given(events)def test_receiver_safety_properties(evts): r, now = Receiver(), 0 for dt, seq, speed, code_ok, delivered in evts: now += dt before = r.speed if delivered: r.on_msg(seq, speed, code_ok, now) if not (delivered and code_ok): # property 1: an invalid or lost message never changes the value assert r.speed == before r.cycle(now) if r.speed != SAFE_SPEED: # property 2: a permissive value is never older than the timeout assert now - r.last_valid_ms <= TIMEOUT_MS
Lost, corrupted, repeated and delayed messages are all generated by the same strategy, so one test explores thousands of fault sequences.
When a property fails, the tool shrinks the input to a minimal counterexample. That is often the clearest description of a design flaw you will get.
Tip
Property-based tests complement the requirements-based tests and coverage measurements that the standards require. They do not replace them. A good use is to explore the state space of a model or a unit early, before the formal test campaign.
Testing the tests
A fault injection campaign is only as good as its ability to fail. Two techniques help to check that:
Error seeding or mutation testing: introduce known faults into the code and check that the test suite detects them. Surviving mutants point to weak tests.
Negative checks of the safety mechanism: temporarily disable a diagnostic in a test build and confirm that the corresponding test fails. If it still passes, it was not testing the diagnostic.
A practical starting point
You do not need a full HIL rig to start:
Take the FMEA (or the hazard log) and list every failure mode for which a detection is claimed.
Write one test per claimed detection at the lowest level where the fault can be injected realistically.
Assert detection, safe state and time, not only “no crash”.
Trace each test to its failure mode and safety requirement.
Add random fault sequences or property-based tests where the state space is too large for hand-written cases.
Common mistakes
Testing only that the function works. The safety mechanisms are the part that needs fault injection, and they are silent on the happy path.
Asserting “no exception” instead of the safe state. Surviving a fault is not the requirement. Reaching the defined safe state is.
Ignoring timing. A test without a time measurement cannot show that the reaction fits within the FTTI.
Choosing faults at random only. Random campaigns are a supplement. The safety case needs systematic coverage of the analysed failure modes.
Leaving fault injection hooks active in the product. Test code that can corrupt data must not be reachable in operation.
Not feeding results back. A failed fault injection test means the analysis was wrong too. Update the FMEA, not only the code.
Standards: EN 50128, EN 50129, EN 50159, ISO 26262 (parts 4, 5 and 6), IEC 61508-7
Większość zestawów testów skupia się na ścieżce pozytywnej (happy path): poprawne dane wejściowe, sprawny sprzęt, komunikaty przychodzące na czas. W systemie związanym z bezpieczeństwem to akurat najmniej ciekawa część.
Argumentacja bezpieczeństwa opiera się na tym, co system zrobi, gdy czujnik się zawiesi, komunikat zostanie przekłamany albo zadanie nie zmieści się w swoim czasie. Podczas zwykłej kampanii testowej takie sytuacje same się nie zdarzą.
Artykuł jest dla inżynierów, którzy weryfikują systemy związane z bezpieczeństwem, a także dla programistów, którzy znają wstrzykiwanie uszkodzeń z systemów rozproszonych i chcą zobaczyć, jak przekłada się ono na bezpieczeństwo funkcjonalne.
Dla kolei odwołuję się do EN 50128 i EN 50129, dla pojazdów drogowych do ISO 26262. Projektową stronę tego samego tematu opisałem w artykule bezpieczeństwo w projektowaniu systemów.
Dlaczego sama ścieżka pozytywna nie wystarczy
Mechanizmy bezpieczeństwa – watchdogi, kontrole wiarygodności, porównanie krzyżowe, limity czasu komunikatów – nic nie robią, dopóki wszystko działa. To uśpiony kod i uśpiony sprzęt, a właśnie w uśpionych częściach chowają się uszkodzenia ukryte.
Są trzy powody, żeby testować je celowo:
Materiał dowodowy do dowodu bezpieczeństwa. Dowód bezpieczeństwa (safety case) deklaruje, że określone uszkodzenia są wykrywane i prowadzą do stanu bezpiecznego. Weryfikacja musi pokazać, że tak jest w rzeczywistej implementacji, a nie tylko na papierze.
Pokrycie diagnostyczne. Wskaźniki sprzętowe w IEC 61508, EN 50129 i ISO 26262 zależą od tego, jaką część uszkodzeń niebezpiecznych wykrywa diagnostyka. Wstrzykiwanie uszkodzeń to jeden ze sposobów, by podeprzeć deklarowane wartości pokrycia.
Czas. Wykrycie, które przychodzi za późno, oznacza, że mechanizm bezpieczeństwa zawiódł. Rzeczywisty czas wykrycia i reakcji pokaże dopiero test z prawdziwym uszkodzeniem.
Important
Kryterium zaliczenia testu rodzaju uszkodzenia nie brzmi „system działał dalej”. Brzmi: „uszkodzenie zostało wykryte, a system przeszedł w zdefiniowany stan bezpieczny w wymaganym czasie”.
Które rodzaje uszkodzeń testować
Tabela zbiera typowe rodzaje uszkodzeń wbudowanego systemu związanego z bezpieczeństwem oraz mechanizmy, które mają je wychwycić.
Kategoria
Przykładowe rodzaje uszkodzeń
Typowy mechanizm bezpieczeństwa
Czujniki i wejścia
Wartość zablokowana, poza zakresem, dryf, zakłócenia, przerwa lub zwarcie
Kontrola zakresu i wiarygodności, porównanie redundantnych czujników
Komunikacja
Przekłamanie, powtórzenie, usunięcie, wstawienie, zmiana kolejności, opóźnienie, podszywanie się
Kod bezpieczeństwa, numery sekwencyjne, limity czasu, identyfikatory nadawcy (EN 50159)
Czas i wykonanie
Przekroczenie czasu zadania, zawieszenie programu, błędny przepływ sterowania
Przekłamania bitów w RAM, uszkodzony ROM, uszkodzona jednostka ALU
Testy pamięci, CRC kodu i danych, autotesty procesora, ECC
Zasilanie i wyjścia
Zanik lub spadek napięcia, wyjście trwale aktywne
Monitorowanie napięcia, odczyt zwrotny wyjść, stan bezpieczny przy braku zasilania
Dane i konfiguracja
Błędne lub niespójne dane konfiguracyjne
Walidacja danych, sumy kontrolne, niezależna kontrola przygotowania danych
Wiersz „Komunikacja” odpowiada liście zagrożeń z EN 50159 – zwykłemu punktowi odniesienia dla komunikacji związanej z bezpieczeństwem w systemach kolejowych.
Inżynierowie systemów rozproszonych rozpoznają większość pozostałych wierszy. To te same rodzaje uszkodzeń co przekroczone limity czasu w sieci, zduplikowane komunikaty czy wyczerpanie zasobów – tyle że wymagana reakcja jest znacznie ostrzejsza.
Od FMEA do przypadków testowych
Analiza rodzajów i skutków uszkodzeń (FMEA) zawiera już większość tego, czego potrzebuje test ze wstrzykiwaniem uszkodzenia. Każdy wiersz podaje rodzaj uszkodzenia, jego skutek, sposób wykrycia i reakcję systemu. Skoro analiza deklaruje wykrycie, kampania testowa powinna je pokazać.
  +---------------+   +-----------------+   +-------------------+
  | Wiersz FMEA:  |-->| Wymaganie dla   |-->| Przypadek testowy |
  | rodzaj        |   | mechanizmu      |   | (wstrzyknięcie,   |
  | uszkodzenia   |   | bezpieczeństwa  |   |  obserwacja stanu |
  | + skutek      |   | (wykrycie,      |   |  bezpiecznego)    |
  +---------------+   |  reakcja, czas) |   +---------+---------+
          ^           +-----------------+             |
          |                                           |
          +-------------- wynik testu ----------------+
                (potwierdza lub koryguje FMEA)
Diagram pokazuje pętlę. Z FMEA wynikają wymagania dla mechanizmów bezpieczeństwa, z wymagań – przypadki testowe, a wyniki testów wracają do analizy.
Jeśli test pokaże, że uszkodzenie nie jest wykrywane albo jest wykrywane za późno, to znaczy, że FMEA była błędna. Poprawić trzeba argumentację bezpieczeństwa, a nie tylko kod.
Tabela pokazuje, jak z jednego wiersza FMEA powstaje przypadek testowy. Wartości są przykładowe.
Pole FMEA
Treść
Element przypadku testowego
Rodzaj uszkodzenia
Czujnik prędkości A zablokowany na ostatniej wartości
Uszkodzenie do wstrzyknięcia: zamrożenie wyjścia czujnika A
Skutek lokalny
Zmierzona prędkość przestaje nadążać za rzeczywistą
Pobudzenie: zmiana rzeczywistej (symulowanej) prędkości
Wykrywanie
Porównanie czujnika A z czujnikiem B
Oczekiwane: zgłoszenie uszkodzenia z powodu rozbieżności
Reakcja
Stan bezpieczny: polecenie hamowania
Oczekiwane: wydanie polecenia hamowania
Wymaganie czasowe
Wykrycie i reakcja w granicach FTTI
Pomiar: czas od wstrzyknięcia do polecenia hamowania
Pracując z FMEA i FTA przy kolejowych systemach związanych z bezpieczeństwem, przekonałem się, że najwięcej daje jeden nawyk: jawne utrzymywanie tego powiązania w narzędziu do zarządzania wymaganiami – rodzaj uszkodzenia → wymaganie bezpieczeństwa → przypadek testowy → wynik.
Luka w dowolnym miejscu tego łańcucha to luka w argumentacji bezpieczeństwa – i ktoś przy przeglądzie na pewno ją znajdzie.
Techniki wstrzykiwania uszkodzeń
Uszkodzenia można wstrzykiwać na różnych poziomach. Im bliżej rzeczywistego systemu, tym test jest bardziej realistyczny, ale też trudniej go kontrolować i powtarzać.
Poziom
Jak wstrzykuje się uszkodzenia
Do czego się nadaje
Model lub symulacja
Uszkodzenia włączane w modelu systemu lub obiektu sterowania
Wczesne sprawdzenie koncepcji bezpieczeństwa i czasów reakcji
Moduł oprogramowania
Zaślepki i mocki zwracają błędy, niepoprawne wartości lub spóźnione odpowiedzi
Kod defensywny, ścieżki obsługi błędów, walidacja wejść
Integracja oprogramowania
Przekłamane zmienne lub komunikaty przez hooki testowe albo debugger
Interfejsy między komponentami, obsługa błędów od początku do końca
Hardware-in-the-loop
Symulatory sygnałów, wstrzykiwanie błędów na magistrali, uszkodzenia na wyprowadzeniach
Diagnostyka, czasy, współdziałanie sprzętu i oprogramowania
System
Odłączone przewody, przerwy w zasilaniu, przekłamane telegramy
Walidacja dowodu bezpieczeństwa na rzeczywistej konfiguracji
Programowe wstrzykiwanie uszkodzeń
Na poziomie modułu i integracji najprostszy sposób to podmiana zależności na zaślepkę, która zachowuje się źle: zwraca kod błędu, wartość spoza zakresu albo nie zwraca nic. Test sprawdza wtedy, czy badany komponent reaguje zgodnie ze specyfikacją.
To ten sam pomysł co mockowanie niedziałającego klienta HTTP w usłudze webowej. Różni się oczekiwany wynik: zdefiniowana bezpieczna reakcja, a nie tylko „brak awarii”.
Hooki testowe (test hooks), które przekłamują dane w czasie działania, dają duże możliwości, ale to dodatkowy kod w produkcie. Usuń je z wersji wydawanej albo wykaż, że w eksploatacji nie da się ich uruchomić.
Wstrzykiwanie na poziomie sprzętu i systemu
Na stanowisku hardware-in-the-loop i na poziomie systemu uszkodzenia wprowadza się do rzeczywistych sygnałów: wejście czujnika wymuszone na stałą wartość, magistrala z przekłamanymi ramkami, chwilowy spadek napięcia zasilania.
Takie testy pokazują rzeczywiste czasy wykrycia i reakcji, z uwzględnieniem sprzętu i systemu operacyjnego. Test modułowy tego nie pokaże.
Co mówią normy
ISO 26262 wymienia testy ze wstrzykiwaniem uszkodzeń (fault injection testing) wśród metod weryfikacji sprzętu, oprogramowania i zintegrowanego systemu – im wyższy ASIL, tym mocniejsze zalecenie.
EN 50128 nie używa pojęcia inżynierii chaosu, ale jej katalog technik obejmuje techniki pokrewne, również dobierane według poziomu nienaruszalności bezpieczeństwa oprogramowania:
analizę wartości granicznych,
zgadywanie błędów (error guessing),
zasiewanie błędów (error seeding),
testy lawinowe i przeciążeniowe (avalanche/stress testing).
Zawsze sprawdzaj tabele technik w tym wydaniu normy, które obowiązuje w Twoim projekcie. Nazwy technik i poziomy zaleceń różnią się między normami i między wydaniami.
Inżynieria chaosu okiem inżyniera bezpieczeństwa
Inżynieria chaosu (chaos engineering) wyrosła z dużych usług internetowych. Zespoły celowo wyłączają instancje, dokładają opóźnienia albo zrywają połączenia sieciowe na produkcji, żeby sprawdzić, czy usługa pozostaje dostępna.
Przewidź, że utrzyma się on po wystąpieniu określonego uszkodzenia.
Wstrzyknij uszkodzenie i porównaj wynik z przewidywaniem.
Takie podejście oparte na hipotezie przydaje się także w inżynierii bezpieczeństwa. Różnica leży w samej hipotezie i w środowisku.
Aspekt
Inżynieria chaosu (usługi IT)
Wstrzykiwanie uszkodzeń w systemach bezpieczeństwa
Hipoteza
Usługa pozostaje dostępna mimo uszkodzenia
System wykrywa uszkodzenie i na czas przechodzi w stan bezpieczny
Środowisko
Często produkcja, z ograniczonym zasięgiem skutków
Laboratorium, stanowisko testowe, HIL lub tor doświadczalny – nigdy ruch planowy
Dobór uszkodzeń
Losowy lub na podstawie doświadczenia
Systematyczny, wyprowadzony z FMEA, FTA i rejestru zagrożeń
Miara sukcesu
Odsetek błędów i opóźnienia w dopuszczalnych granicach
Wykrycie, stan bezpieczny i czas zgodne ze specyfikacją
Materiał dowodowy
Dashboardy i analizy poawaryjne (post-mortem)
Specyfikacje testów, raporty i śledzenie powiązań na potrzeby dowodu bezpieczeństwa
Nigdy nie wstrzykuj uszkodzeń do systemu, który pełni funkcje bezpieczeństwa w eksploatacji
Wstrzykiwanie uszkodzeń do pociągu, pojazdu albo urządzeń zależnościowych w eksploatacji oznacza poleganie na tych samych mechanizmach bezpieczeństwa, które dopiero próbujesz sprawdzić. Rób to w kontrolowanym środowisku testowym, z niezależnymi zabezpieczeniami.
Z inżynierii chaosu warto przejąć przede wszystkim nastawienie: zakładaj, że istnieją rodzaje uszkodzeń, których nikt nie wpisał do FMEA, i szukaj ich celowo.
Losowe kampanie uszkodzeń na stanowisku testowym mogą uzupełniać systematyczne testy wyprowadzone z FMEA. Czasem ujawniają kombinacje, które analiza przeoczyła.
Testy oparte na właściwościach dla wymagań bezpieczeństwa
Testy oparte na przykładach sprawdzają pojedyncze scenariusze. Testy oparte na właściwościach (property-based testing) formułują właściwość, która musi być spełniona dla wszystkich danych wejściowych. Narzędzie generuje wtedy mnóstwo losowych wejść i sekwencji zdarzeń, szukając kontrprzykładu.
Wymagania bezpieczeństwa często są już zapisane właśnie w takiej postaci:
„Wyjście nigdy nie jest bardziej zezwalające, niż pozwalają na to wejścia”.
„Niepoprawny komunikat nigdy nie zmienia wartości używanej przez funkcję bezpieczeństwa”.
„Jeśli przez czas dłuższy niż limit nie nadszedł żaden poprawny komunikat, obowiązuje wartość bezpieczna”.
Poniższy szkic sprawdza dwie ostatnie właściwości na pythonowym modelu bezpiecznego odbiornika komunikatów z artykułu bezpieczeństwo w projektowaniu systemów. Korzysta z biblioteki Hypothesis. To przykład na poziomie modelu, a nie test rzeczywistego kodu w C.
from hypothesis import given, strategies as stSAFE_SPEED = 0 # wartość najbardziej restrykcyjnaTIMEOUT_MS = 500class Receiver: def __init__(self): self.last_seq = 0 self.last_valid_ms = 0 self.speed = SAFE_SPEED def on_msg(self, seq, speed, code_ok, now): if code_ok and seq > self.last_seq: self.last_seq = seq self.last_valid_ms = now self.speed = speed def cycle(self, now): if now - self.last_valid_ms > TIMEOUT_MS: self.speed = SAFE_SPEED# Jedno zdarzenie: krok czasu, numer sekwencyjny, prędkość, kod bezpieczeństwa ok, dostarczonyevents = st.lists(st.tuples( st.integers(0, 2000), st.integers(0, 100), st.integers(0, 300), st.booleans(), st.booleans()))@given(events)def test_receiver_safety_properties(evts): r, now = Receiver(), 0 for dt, seq, speed, code_ok, delivered in evts: now += dt before = r.speed if delivered: r.on_msg(seq, speed, code_ok, now) if not (delivered and code_ok): # właściwość 1: niepoprawny lub utracony komunikat nigdy nie zmienia wartości assert r.speed == before r.cycle(now) if r.speed != SAFE_SPEED: # właściwość 2: wartość zezwalająca nigdy nie jest starsza niż limit czasu assert now - r.last_valid_ms <= TIMEOUT_MS
Komunikaty utracone, przekłamane, powtórzone i opóźnione powstają z tej samej strategii, więc jeden test przechodzi przez tysiące sekwencji uszkodzeń.
Gdy właściwość nie jest spełniona, narzędzie redukuje dane wejściowe do minimalnego kontrprzykładu. Często trudno o czytelniejszy opis wady projektowej.
Tip
Testy oparte na właściwościach uzupełniają wymagane przez normy testy oparte na wymaganiach i pomiary pokrycia. Nie zastępują ich. Najlepiej sprawdzają się we wczesnym badaniu przestrzeni stanów modelu lub modułu, jeszcze przed formalną kampanią testową.
Testowanie testów
Kampania wstrzykiwania uszkodzeń jest tyle warta, ile jej zdolność do wykazania błędu. Sprawdzić to pomagają dwie techniki:
Zasiewanie błędów (error seeding) lub testy mutacyjne: wprowadź do kodu znane błędy i sprawdź, czy zestaw testów je wykryje. Mutanty, które przetrwały, wskazują słabe testy.
Sprawdzenie negatywne mechanizmu bezpieczeństwa: w wersji testowej tymczasowo wyłącz diagnostykę i potwierdź, że odpowiadający jej test nie przechodzi. Jeśli nadal przechodzi, to tej diagnostyki wcale nie testował.
Od czego zacząć
Na początek nie potrzebujesz pełnego stanowiska HIL:
Weź FMEA (albo rejestr zagrożeń) i wypisz wszystkie rodzaje uszkodzeń, dla których deklarowane jest wykrycie.
Dla każdego deklarowanego wykrycia napisz jeden test – na najniższym poziomie, na którym uszkodzenie da się realistycznie wstrzyknąć.
Sprawdzaj wykrycie, stan bezpieczny i czas, a nie tylko „brak awarii”.
Powiąż każdy test z rodzajem uszkodzenia i wymaganiem bezpieczeństwa.
Tam, gdzie przestrzeń stanów jest za duża na ręcznie pisane przypadki, dodaj losowe sekwencje uszkodzeń lub testy oparte na właściwościach.
Typowe błędy
Testowanie tylko tego, czy funkcja działa. To właśnie mechanizmy bezpieczeństwa trzeba sprawdzać wstrzykiwaniem uszkodzeń – na ścieżce pozytywnej w ogóle się nie odzywają.
Sprawdzanie „braku wyjątku” zamiast stanu bezpiecznego. Wymaganiem nie jest przetrwanie uszkodzenia, tylko przejście w zdefiniowany stan bezpieczny.
Pomijanie czasu. Test bez pomiaru czasu nie wykaże, że reakcja mieści się w FTTI.
Wyłącznie losowy dobór uszkodzeń. Kampanie losowe są tylko uzupełnieniem. Dowód bezpieczeństwa wymaga systematycznego pokrycia przeanalizowanych rodzajów uszkodzeń.
Aktywne hooki do wstrzykiwania uszkodzeń w produkcie. Kod testowy, który potrafi przekłamać dane, nie może być osiągalny w eksploatacji.
Brak sprzężenia zwrotnego. Niezaliczony test ze wstrzykiwaniem uszkodzenia oznacza, że błędna była również analiza. Aktualizuj FMEA, nie tylko kod.
EN 50128:2011 and EN 50657:2017 vs their successor EN 50716:2023: dates, scope, clause-by-clause changes, Basic Integrity, roles, tools, languages, and a transition checklist before the 2026 dow.EN 50128:2011 i EN 50657:2017 a ich następczyni EN 50716:2023: daty, zakres, zmiany rozdział po rozdziale, Basic Integrity, role, narzędzia, języki i lista kontrolna przed dow w 2026 r.
Core principles for designing safety-related systems: safe states, defence in depth, fault detection and reaction, containment, and how familiar resilience patterns map to functional safety.Podstawowe zasady projektowania systemów związanych z bezpieczeństwem: stan bezpieczny, obrona w głąb, wykrywanie uszkodzeń i reakcja na nie, izolowanie uszkodzeń oraz miejsce znanych wzorców odporności w bezpieczeństwie funkcjonalnym.
A practical guide to EN 50128:2011: SIL 0-4, roles and independence, the software lifecycle and its documents, Annex A techniques (M/HR/R/NR), tool classes T1-T3, and how it relates to EN 50716.Praktyczny przewodnik po EN 50128:2011: SIL 0–4, role i niezależność, cykl życia oprogramowania i jego dokumenty, techniki z Załącznika A (M/HR/R/NR), klasy narzędzi T1–T3 oraz związek z EN 50716.